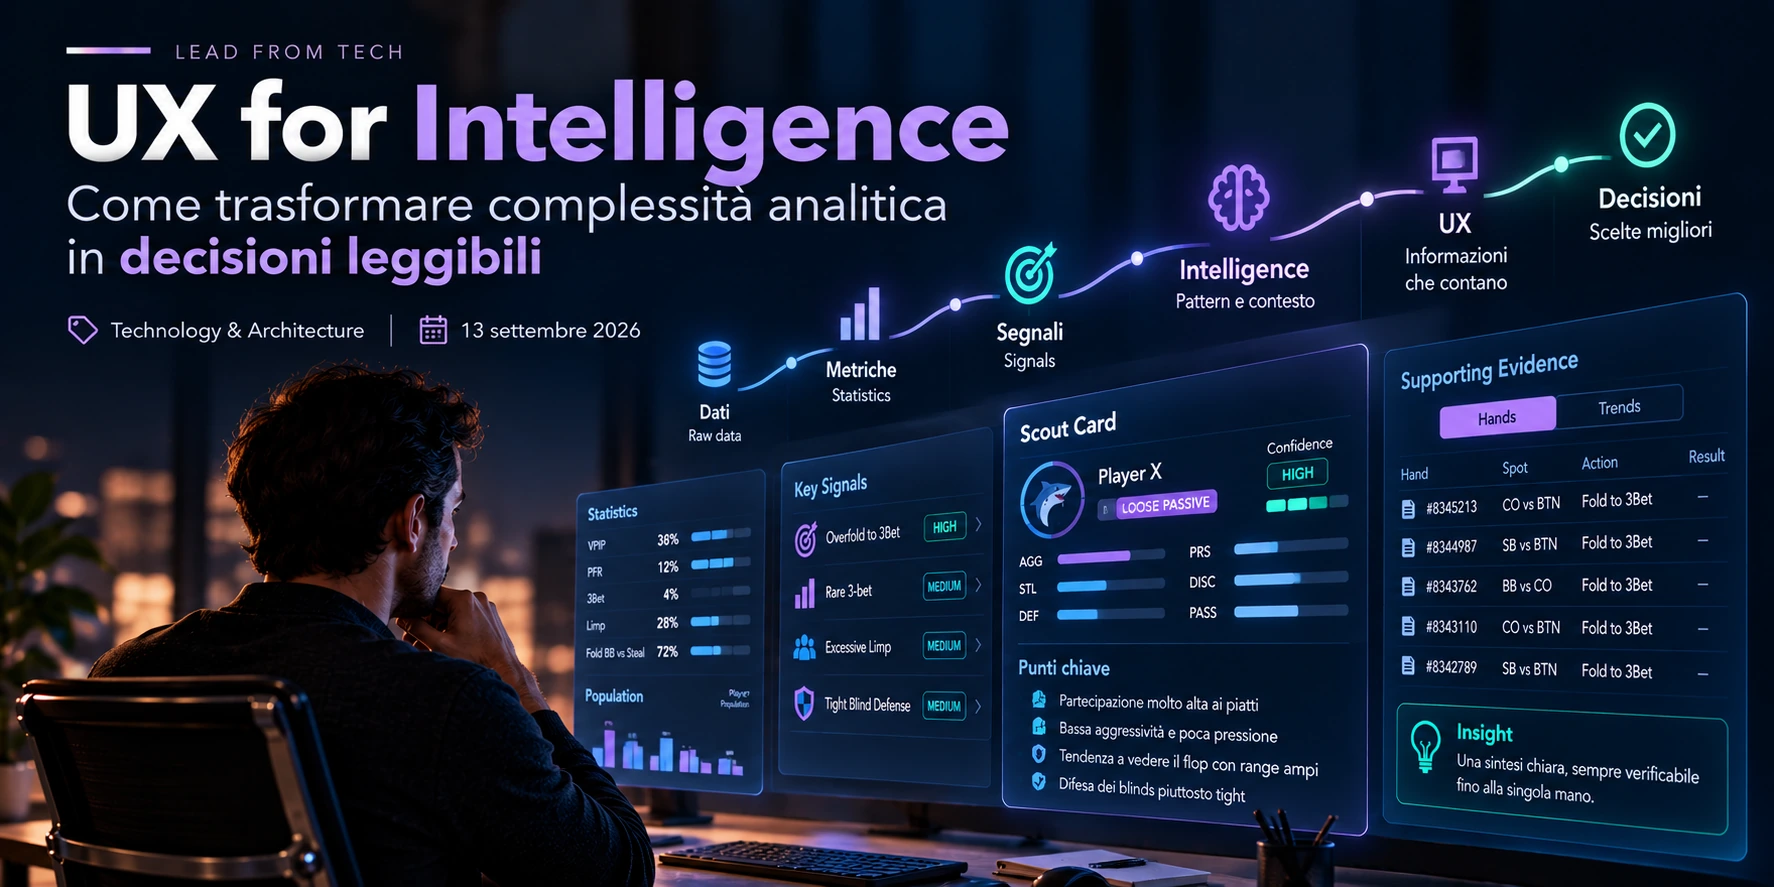
Nel precedente Insight, Da statistiche a intelligence: costruire un motore che interpreta i comportamenti, siamo arrivati a costruire qualcosa che va oltre una dashboard.
Metriche.
Opportunities.
Confidence.
Benchmark.
Signals.
Archetipi.
Evidenze.
Controevidenze.
Dal punto di vista analitico, è un risultato.
Dal punto di vista dell’utente, può diventare un problema.
Perché più il sistema diventa capace di interpretare i dati, più aumenta la quantità di informazione che potrebbe mostrare.
E se mostriamo tutto contemporaneamente, rischiamo un paradosso:
abbiamo ridotto la complessità nei dati per ricrearla nell’interfaccia.
È qui che la UX smette di essere una questione estetica.
Diventa parte del sistema di intelligence.
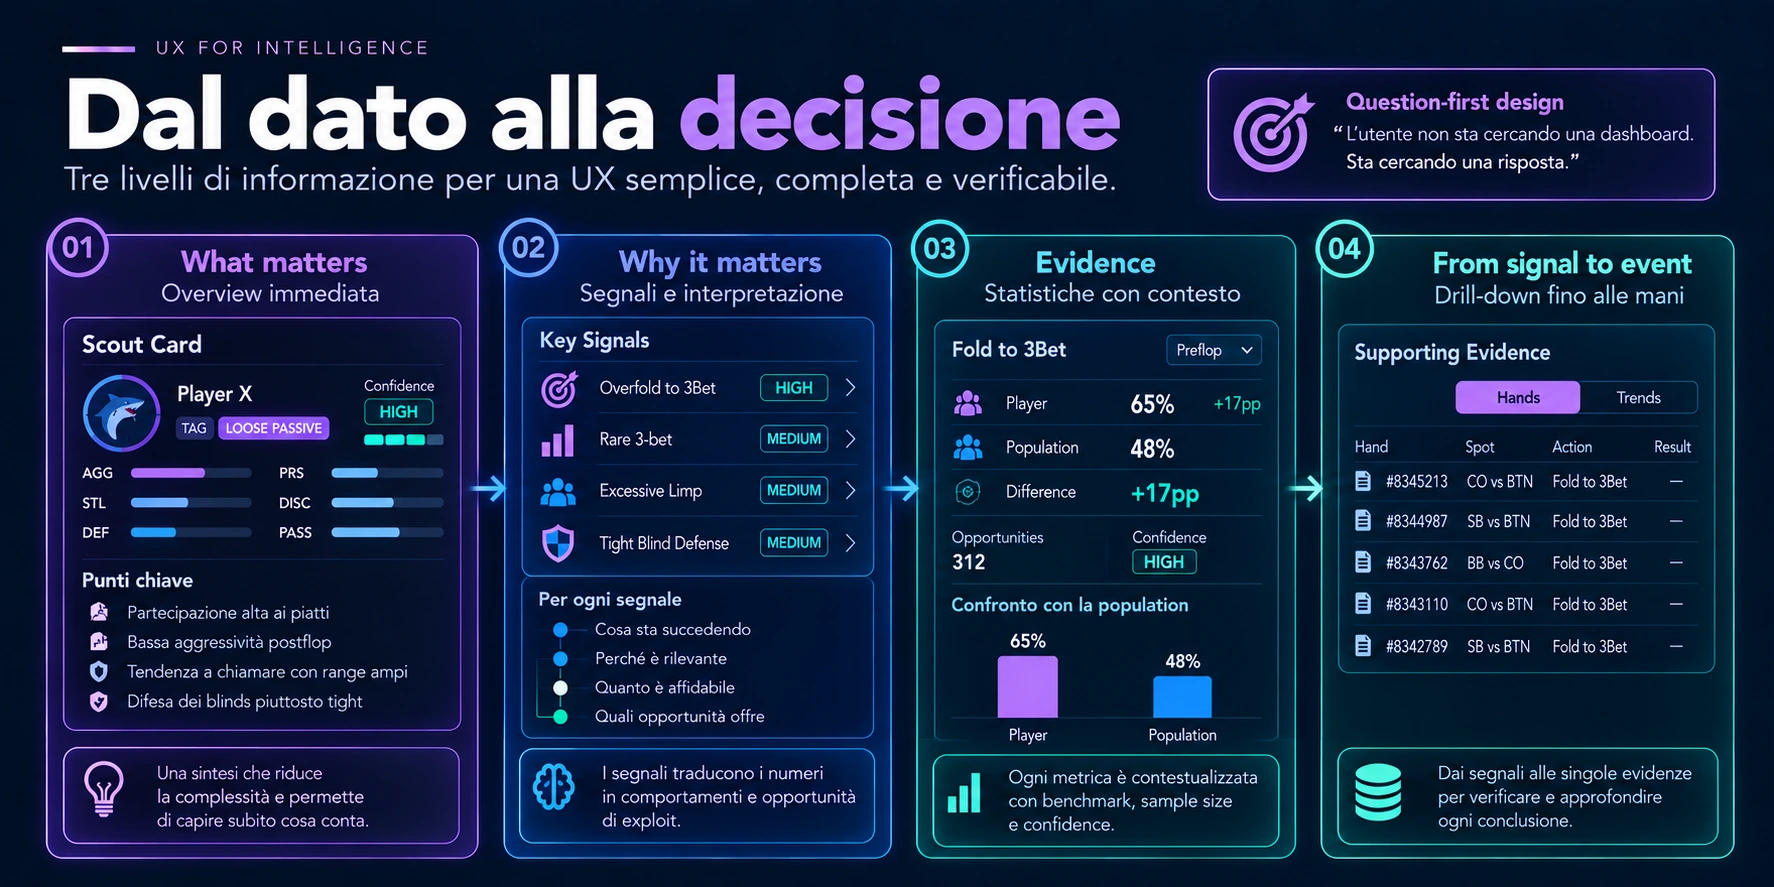
L’utente non sta cercando una dashboard
Quando progettiamo un prodotto data-intensive è facile partire da ciò che abbiamo costruito.
Abbiamo venti statistiche?
Creiamo venti widget.
Abbiamo benchmark?
Aggiungiamo una colonna.
Abbiamo confidence?
Mettiamo un badge.
Abbiamo signals?
Creiamo un’altra sezione.
Tecnicamente funziona.
Ma il risultato rischia di essere quello che chiamo dashboard theatre: un’interfaccia apparentemente ricca, piena di numeri, grafici e indicatori, che trasferisce sull’utente tutto il lavoro interpretativo.
Il punto è che l’utente non sta cercando una dashboard.
Sta cercando una risposta.
Nel mio caso, domande come:
Che tipo di comportamento sto osservando?
Quali pattern meritano attenzione?
Quanto posso fidarmi di questa conclusione?
Quali dati la sostengono?
La progettazione dell’interfaccia dovrebbe partire da queste domande.
Non dai componenti disponibili.
Question-first design
Questo mi ha portato a una distinzione che considero utile.
Component-first design
Ho una tabella, un grafico, una card. Quali dati posso mostrarci?
Question-first design
Quale domanda deve riuscire a risolvere l’utente? Qual è la quantità minima di informazione necessaria per aiutarlo?
Il secondo approccio cambia il modo in cui organizziamo l’interfaccia.
Non significa eliminare il dettaglio.
Significa decidere quando mostrarlo.
Tre livelli di informazione
La struttura che ha iniziato a funzionare meglio era molto semplice:
Level 1 → What matters
Level 2 → Why it matters
Level 3 → Evidence
In altre parole:
overview → explanation → evidence
Al primo livello voglio capire immediatamente cosa merita attenzione.
Al secondo voglio capire perché.
Al terzo voglio poter verificare le evidenze.
Questa gerarchia permette di mantenere nello stesso prodotto due caratteristiche che sembrano in conflitto:
semplicità ed explainability.
L’interfaccia può essere semplice senza essere superficiale.
La complessità rimane disponibile.
Non viene semplicemente mostrata tutta insieme.
Progressive disclosure
È qui che entra in gioco la progressive disclosure.
Invece di presentare immediatamente ogni informazione disponibile, l’interfaccia costruisce un percorso.
Nel mio caso:
Scout Card
↓
Signals
↓
Statistics
↓
Hands
Ogni livello risponde a una domanda diversa.
La Scout Card dice:
che tipo di comportamento sto osservando?
I signals spiegano:
quali pattern hanno prodotto questa lettura?
Le statistiche mostrano:
quali numeri sostengono quei pattern?
Le singole mani permettono infine di verificare:
quali eventi reali hanno generato quei numeri?
Questa struttura crea una proprietà importante:
ogni sintesi può essere attraversata al contrario fino ai fatti.
Non devo scegliere tra una UI semplice e una UI verificabile.
Posso avere entrambe.
La Scout Card come compressione cognitiva
Uno degli esperimenti più interessanti è stato proprio la Scout Card.
L’obiettivo non era creare una scheda più bella.
Era comprimere molte informazioni in una rappresentazione che potesse essere letta rapidamente.
Invece di mostrare immediatamente decine di statistiche, la card sintetizza elementi come:
- archetipo;
- confidence;
- aggressività;
- propensione allo steal;
- difesa;
- pressione;
- disciplina;
- passività.
Non sostituisce le statistiche.
Le comprime.
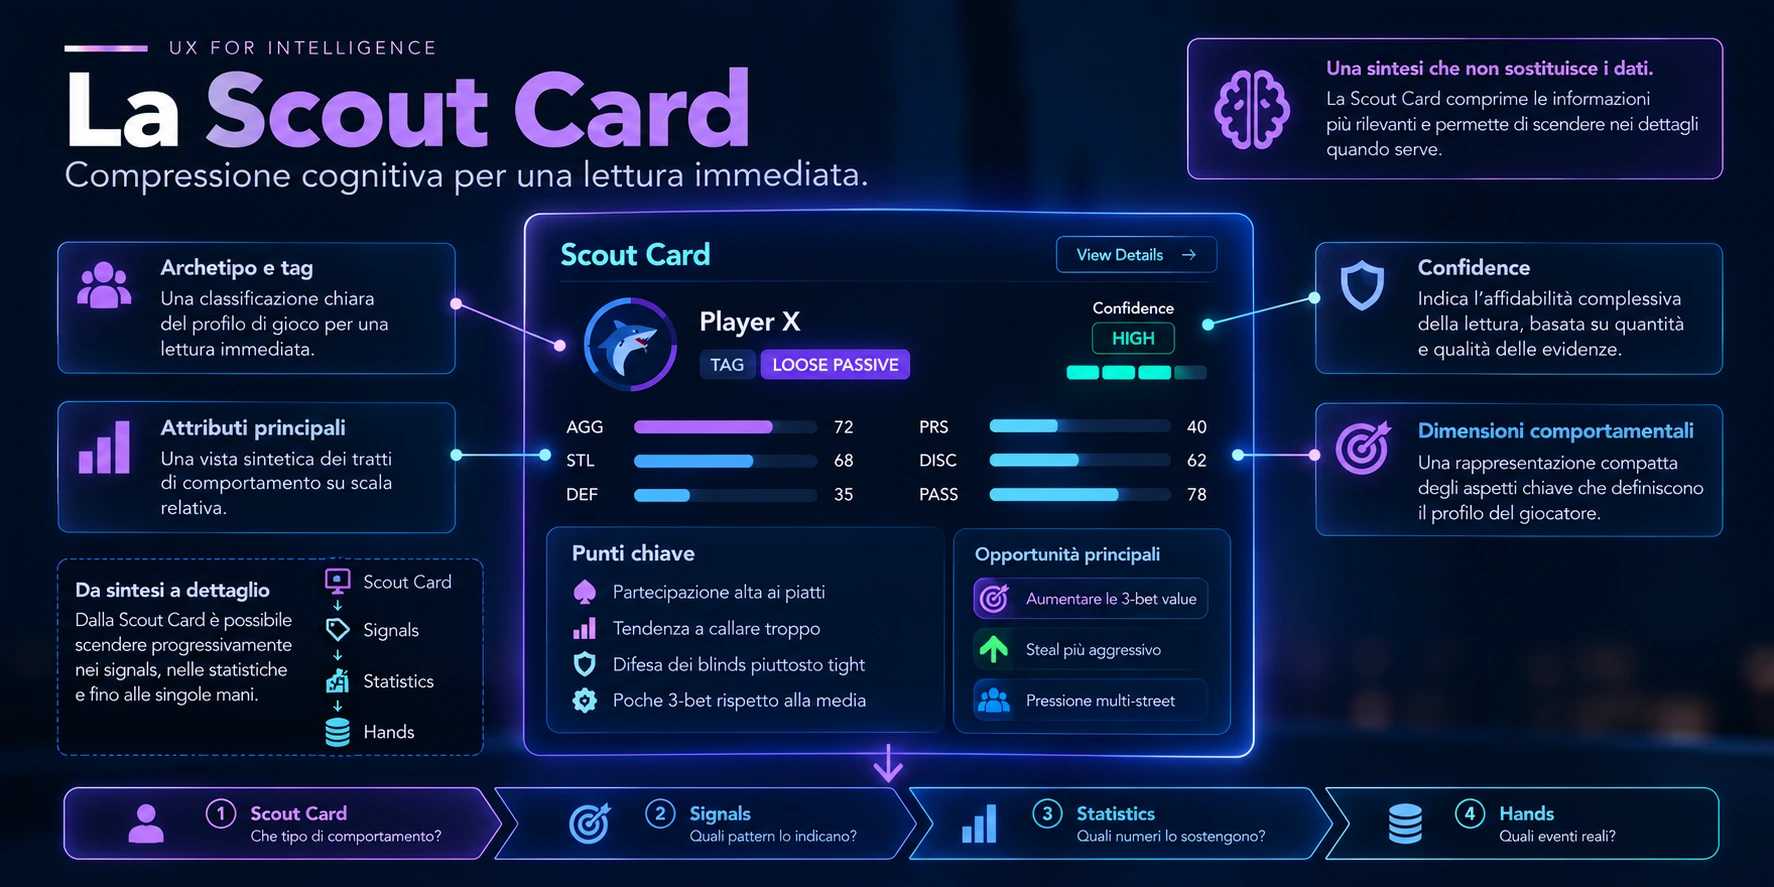
Questa distinzione è importante.
Una buona sintesi non elimina l’informazione.
Riduce il costo cognitivo necessario per iniziare a comprenderla.
L’utente può fermarsi alla Scout Card se gli basta una lettura veloce.
Oppure può scendere nei signals.
Poi nelle metriche.
Poi nelle evidenze.
Densità informativa non significa mostrare tutto
Un’interfaccia analitica può essere molto densa e rimanere leggibile.
Il problema non è necessariamente la quantità di informazione.
È la quantità di informazione senza gerarchia.
Se colore, dimensione, posizione, tipografia e spazio hanno tutti lo stesso peso, ogni elemento compete con gli altri.
L’utente deve decidere da solo dove guardare.
Una gerarchia efficace dovrebbe invece suggerire:
- guarda prima questo;
- se ti interessa, approfondisci qui;
- se vuoi verificarlo, queste sono le evidenze.
La UI diventa così una guida alla lettura.
Non soltanto un contenitore di dati.
Anche lo stato del dato deve essere visibile
Un numero può essere corretto e contemporaneamente poco affidabile.
Questo era già emerso parlando di sample size e confidence.
Nell’interfaccia, però, quella distinzione deve essere percepibile.
Immaginiamo:
3Bet: 18%
Da solo può sembrare estremamente significativo.
Ma se deriva da:
5 opportunities
la lettura cambia.
Per questo confidence e sample non dovrebbero essere informazioni nascoste in una schermata secondaria.
Devono essere vicine alla metrica quando influenzano direttamente il suo significato.
Non necessariamente dominanti.
Ma disponibili.
Ranking senza contesto
Lo stesso problema emerge quando iniziamo a ordinare giocatori o comportamenti.
Una classifica del tipo:
Player A — 72%
Player B — 68%
Player C — 64%
sembra molto precisa.
Ma potrebbe nascondere:
Player A — 72% — 18 opportunities
Player B — 68% — 340 opportunities
Player C — 64% — 512 opportunities
La classifica non è falsa.
È semplicemente incompleta.
E l’interfaccia può amplificare questa incompletezza trasformando una differenza numerica in una gerarchia visivamente molto forte.
Per questo ranking, sample e confidence dovrebbero essere progettati insieme.
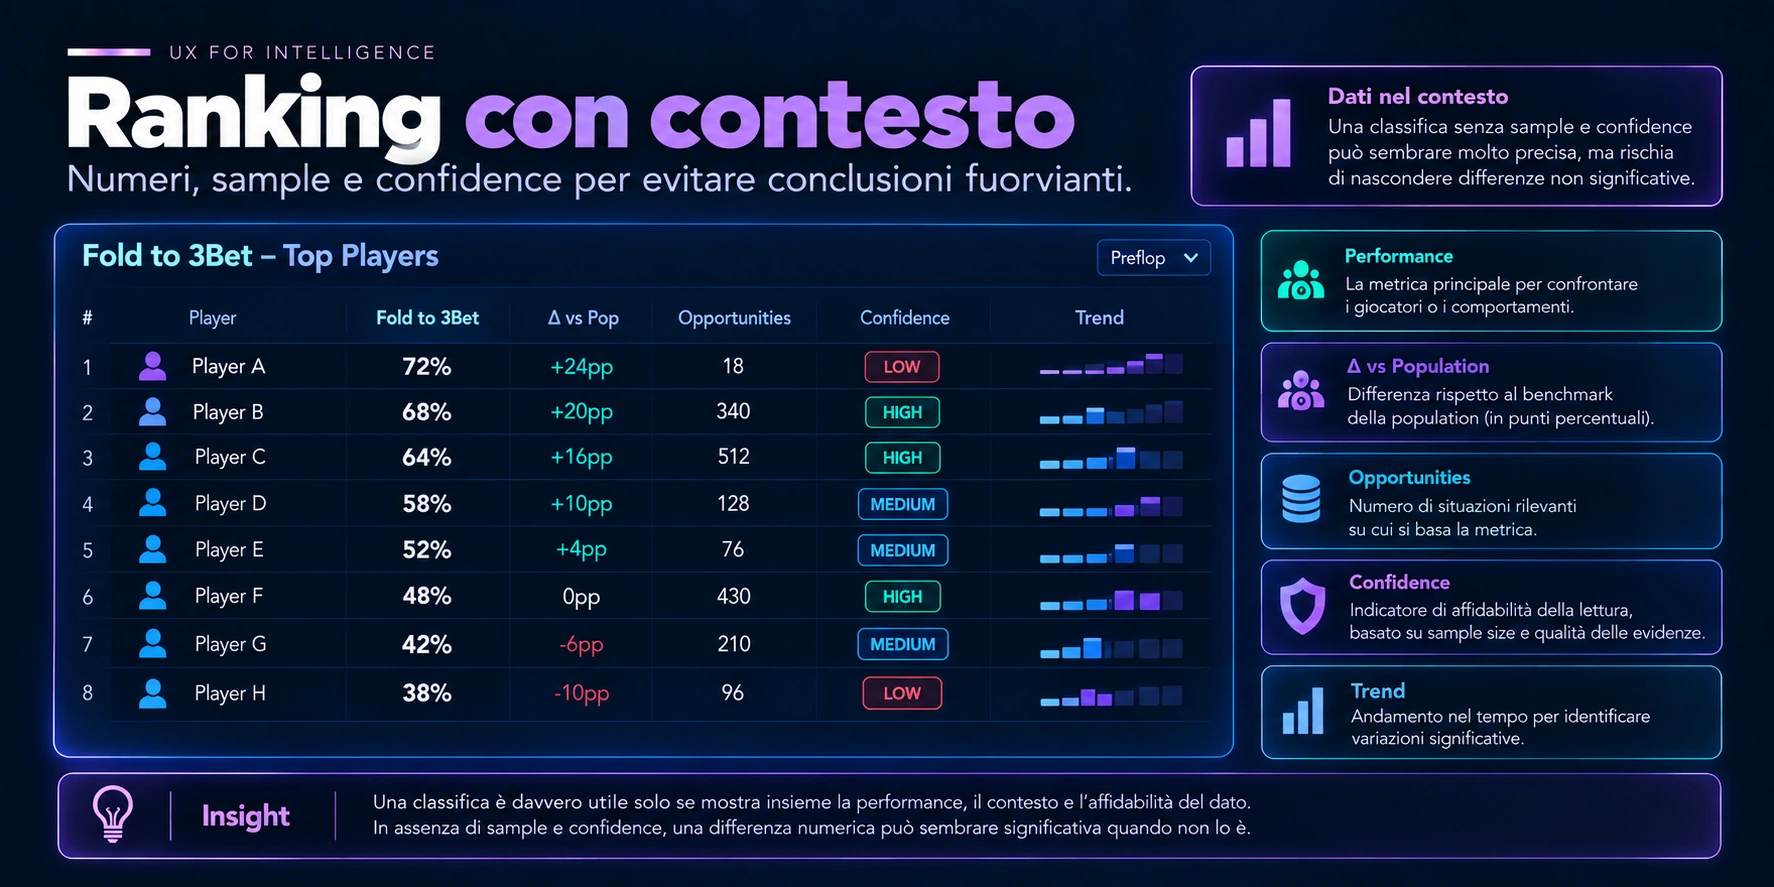
La UX non deve soltanto rendere i dati leggibili.
Deve evitare di renderli più certi di quanto siano realmente.
Il benchmark deve stare vicino alla metrica
C’è poi il tema del contesto.
Se mostro:
Fold to 3Bet: 65%
e il benchmark della population si trova tre schermate più avanti, sto chiedendo all’utente di mantenere mentalmente il primo valore mentre cerca il secondo.
È un costo cognitivo inutile.
Molto meglio:
Player 65%
Population 48%
Δ +17pp
Quando il confronto è parte dell’interpretazione, dovrebbe essere parte anche della rappresentazione.
Questo principio sembra banale.
Ma applicato sistematicamente cambia molto la leggibilità di un prodotto analitico.
Explainability non significa mostrare tutto subito
Un altro rischio è interpretare l’explainability come obbligo di mostrare ogni dettaglio.
Non è così.
Un signal potrebbe apparire inizialmente come:
Overfold to 3Bet
Confidence: HIGH
Se l’utente vuole capire perché, può aprirlo.
A quel punto trova:
Fold to 3Bet → 65%
Population → 48%
Difference → +17pp
Opportunities → 312
e le relative supporting evidence e counterevidence.
Se vuole andare ancora più in profondità, può arrivare agli eventi.
Signal
↓
Metric
↓
Opportunities
↓
Events
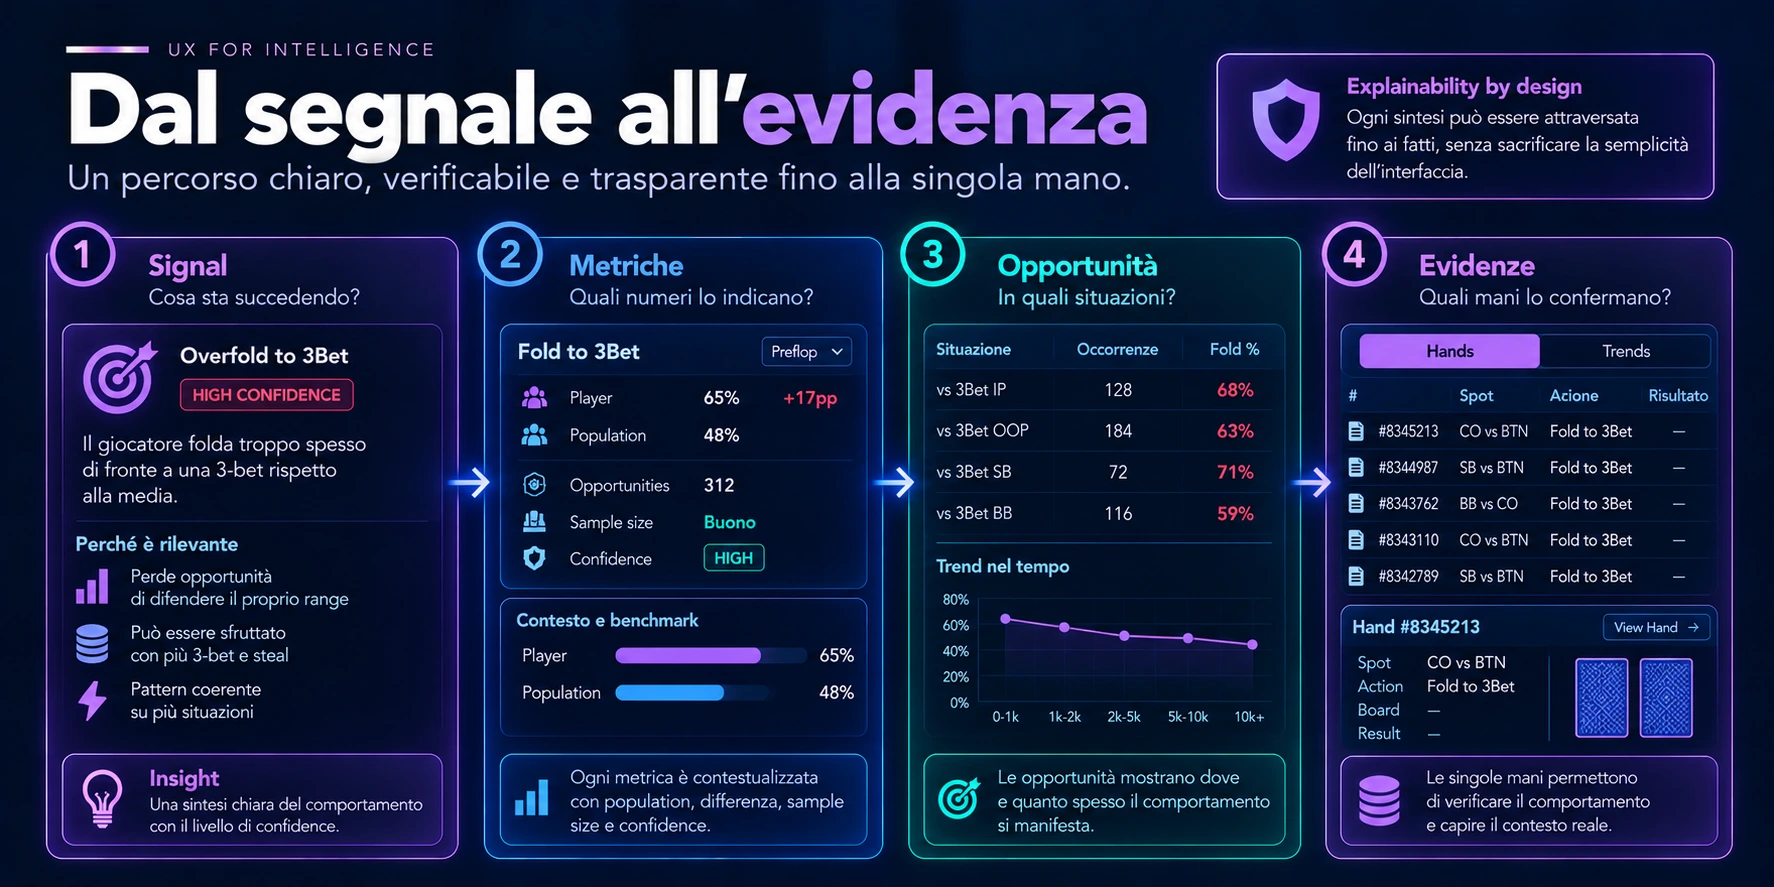
Questo è il punto in cui progressive disclosure ed explainability diventano la stessa architettura vista da due prospettive.
Una riguarda quanto mostrare.
L’altra riguarda quanto poter verificare.
La UI come parte del modello
Lavorando su questo problema mi sono accorto che alcune decisioni apparentemente di frontend stavano in realtà facendo emergere requisiti del dominio.
Se voglio mostrare la confidence accanto a una statistica, devo avere una definizione coerente della confidence.
Se voglio confrontare player e population, devo avere benchmark compatibili.
Se voglio permettere il drill-down da un signal alle evidenze, devo preservare quella relazione nel modello.
Se voglio mostrare counterevidence, il motore deve produrla.
La UI non arriva quindi semplicemente alla fine del processo.
Può diventare uno strumento per scoprire ciò che manca nell’architettura.
Una schermata difficile da spiegare spesso segnala un modello difficile da spiegare.
La migliore interfaccia non mostra quanto è intelligente il sistema
Quando costruiamo qualcosa di tecnicamente complesso è naturale volerlo mostrare.
Più metriche.
Più grafici.
Più indicatori.
Più automazione.
Ma l’utente non dovrebbe percepire la complessità del sistema come prova del suo valore.
Dovrebbe percepire chiarezza.
Se dietro una Scout Card ci sono centinaia di eventi, decine di metriche, benchmark e regole interpretative, l’interfaccia non deve necessariamente esibirli tutti.
Deve renderli disponibili quando servono.
Il lavoro difficile rimane dietro.
La decisione diventa più semplice davanti.
Dalla complessità alla decisione
Guardando l’intera pipeline, il percorso è diventato:
raw data
→ facts
→ statistics
→ confidence
→ benchmark
→ signals
→ intelligence
→ UX
→ decision
L’ultimo passaggio non è un dettaglio cosmetico.
Possiamo avere dati affidabili e intelligence corretta, ma se l’utente non riesce a capire:
- cosa conta;
- perché conta;
- quanto è affidabile;
- da dove deriva;
il sistema non ha ancora completato il proprio lavoro.
È per questo che considero la UX parte dell’intelligence.
Non perché debba decidere al posto dell’utente.
Ma perché deve trasformare la complessità interna del sistema in qualcosa che una persona possa comprendere, verificare e utilizzare.
La regola che mi porto dietro è semplice:
mostrare prima ciò che conta, senza nascondere ciò che serve per verificarlo.
Pubblicato originariamente su LinkedIn il 13 settembre 2026. Questa edizione fa parte degli Insights di Lead From Tech.