Nel precedente Insight, Il numero non basta: sample size, opportunities e confidence, siamo arrivati a un punto preciso.
Una statistica, da sola, non basta.
Per interpretarla servono almeno il contesto in cui è stata osservata, il numero di opportunità che l’hanno generata e un’indicazione della solidità dell’evidenza disponibile.
La progressione era:
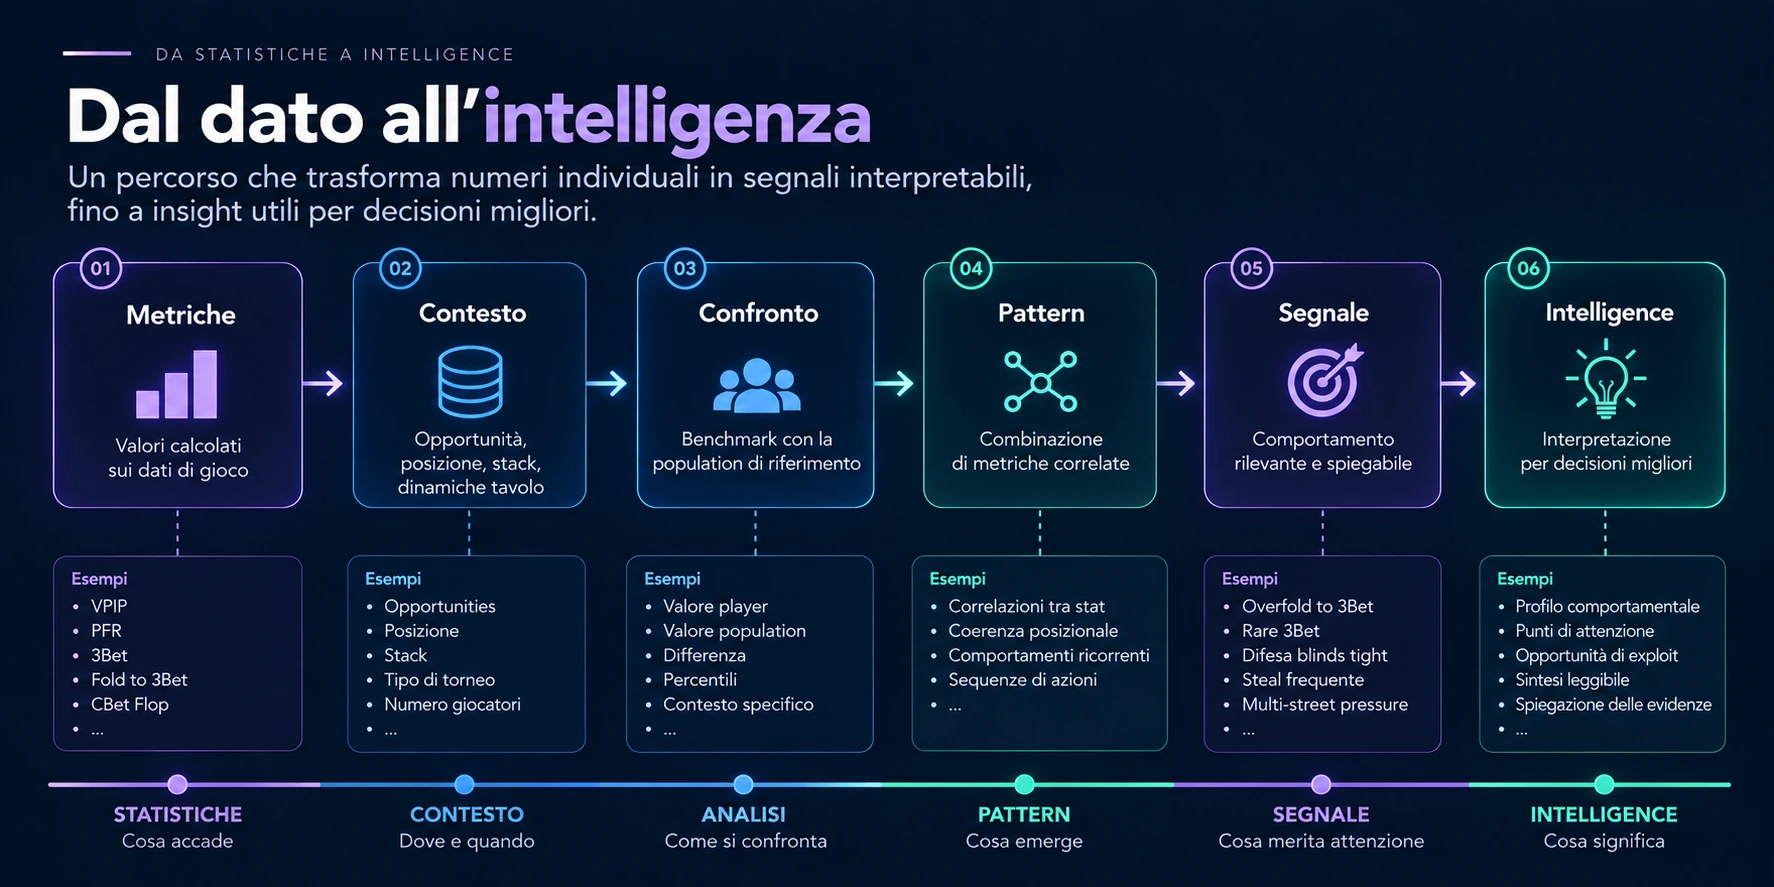
dato affidabile → opportunity → statistica → sample size → confidence → segnale
Ma proprio l’ultimo elemento apre una domanda nuova.
Quando una statistica può diventare un segnale?
E soprattutto: cosa succede quando più segnali iniziano a descrivere uno stesso comportamento?
È qui che un sistema di analytics può iniziare a trasformarsi in qualcosa di diverso.
Un motore di intelligence.
Una dashboard non interpreta
Immaginiamo di avere davanti una scheda con decine di statistiche:
- VPIP;
- PFR;
- 3Bet;
- Fold to 3Bet;
- ATS;
- Fold BB vs Steal;
- CBet Flop;
- CBet Turn;
- Fold to CBet;
- aggressività postflop;
- frequenze per posizione.
Potrebbero essere tutte perfettamente calcolate.
Potrebbero avere campioni sufficienti.
Potrebbero persino mostrare opportunities e confidence.
Eppure rimarrebbe ancora una domanda:
che cosa significa tutto questo?
La dashboard descrive.
L’utente interpreta.
Il problema che volevo affrontare era proprio quello spazio tra le due cose.
Non sostituire la decisione dell’utente.
Ma ridurre il lavoro necessario per arrivare alle osservazioni che meritano davvero attenzione.
Una metrica non è un pattern
Prendiamo una statistica apparentemente semplice:
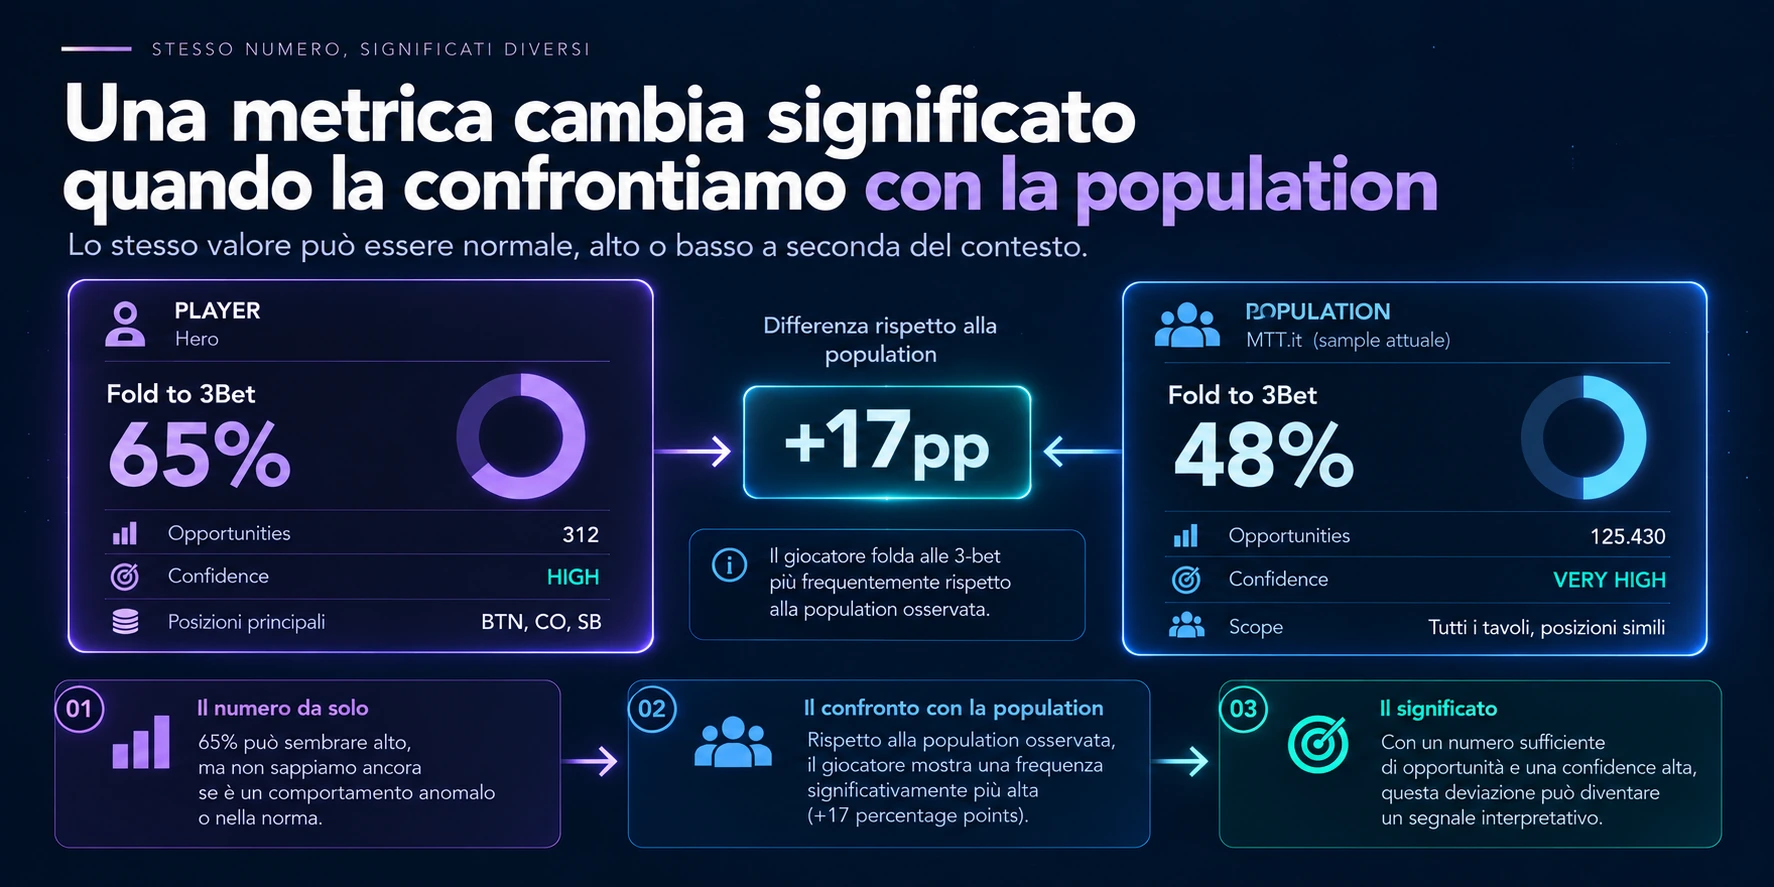
Fold to 3Bet = 65%
Isolata, dice poco.
Potrebbe essere alta.
Potrebbe essere normale.
Potrebbe dipendere dal tipo di giocatori presenti nel campione.
Potrebbe derivare da poche opportunities.
Potrebbe cambiare significativamente in base alla posizione.
Per iniziare a interpretarla serve contesto.
Per esempio:
Player: 65%
Population: 48%
Difference: +17 percentage points
A questo punto non stiamo più osservando soltanto un valore.
Stiamo osservando una deviazione rispetto a un riferimento.
E se quella deviazione è sostenuta da un campione sufficientemente affidabile, può iniziare a diventare un segnale.
Dal valore al segnale
Il passaggio concettuale è importante.
Una metrica risponde:
“quanto spesso accade questo comportamento?”
Un segnale prova invece a rispondere:
“questo comportamento è abbastanza significativo da meritare attenzione?”
Nel motore che stavo costruendo, un segnale non doveva quindi nascere da una semplice soglia.
Non volevo qualcosa del tipo:
Fold to 3Bet > 60% → overfolder
Perché sarebbe troppo fragile.
Una regola più utile deve poter considerare contemporaneamente:
- valore della metrica;
- opportunities;
- confidence;
- benchmark della population;
- distanza dal benchmark;
- eventuale contesto posizionale;
- altre evidenze coerenti;
- possibili controevidenze.
Il segnale diventa quindi il risultato di una combinazione di evidenze, non di un singolo numero.
Il benchmark cambia la domanda
Il confronto con la population è stato uno dei passaggi più importanti.
Senza benchmark posso dire:
“questo giocatore folda il 65% delle volte alle 3-bet.”
Con un benchmark posso dire:
“nel campione disponibile, questo giocatore folda alle 3-bet più frequentemente rispetto alla population osservata.”
È una differenza sostanziale.
La prima frase descrive.
La seconda contestualizza.
Ma anche qui serve cautela.
Il benchmark non rappresenta una verità universale.
Rappresenta la popolazione osservata dal sistema in quel momento.
Cambia il dataset, può cambiare il riferimento.
Per questo anche la population intelligence deve conservare il legame con i dati da cui deriva.
Un segnale deve poter spiegare perché esiste
Se il sistema mostra:
Rare 3Bet
la prima domanda dovrebbe essere:
perché?
Se la risposta è nascosta nel codice, abbiamo costruito una black box.
Io volevo invece che il sistema potesse ricostruire il percorso:
3Bet individuale
→ benchmark population
→ differenza osservata
→ opportunities
→ confidence
→ evidenze di supporto
→ eventuali controevidenze
→ signal
Questo trasforma l’explainability da dettaglio dell’interfaccia a proprietà dell’architettura.
Ogni conclusione deve poter tornare alle evidenze che l’hanno generata.
Metric confidence e signal confidence non sono la stessa cosa
Qui emerge un’altra distinzione importante.
La metric confidence riguarda la solidità di una singola statistica.
Per esempio:
Fold to 3Bet = 65%
può avere confidence alta perché deriva da un numero sufficiente di opportunities.
Ma il segnale:
Overfold to 3Bet
può dipendere da più elementi.
Non soltanto da quella statistica.
Potrebbe considerare:
- distanza dalla population;
- comportamento per posizione;
- coerenza con altre metriche;
- eventuali controevidenze.
Di conseguenza, anche il segnale ha una propria confidence.
Possiamo avere:
metric confidence: HIGH
ma:
signal confidence: MEDIUM
perché le evidenze complessive non sono ancora abbastanza convergenti.
Questa separazione evita di confondere:
“mi fido del numero”
con:
“mi fido dell’interpretazione che sto costruendo partendo da quel numero.”
Supporting evidence e counterevidence
Una delle idee che considero più importanti è che un motore di intelligence non dovrebbe cercare soltanto conferme.
Se sto valutando il segnale:
“difesa dei blind troppo tight”
potrei trovare diverse metriche che lo supportano.
Ma potrei trovare anche evidenze che vanno nella direzione opposta.
Queste informazioni non dovrebbero essere ignorate.
Dovrebbero essere parte del modello.
In termini concettuali:
supporting evidence
e
counterevidence
contribuiscono entrambe alla confidence del segnale.
È una differenza importante rispetto a un sistema costruito come
semplice insieme di if.
Il suo compito non è dimostrare che una regola è vera.
È valutare quanto le evidenze disponibili sostengano una determinata interpretazione.
Da segnali ad archetipi
Quando più segnali iniziano a convergere, possiamo salire ancora di un livello.
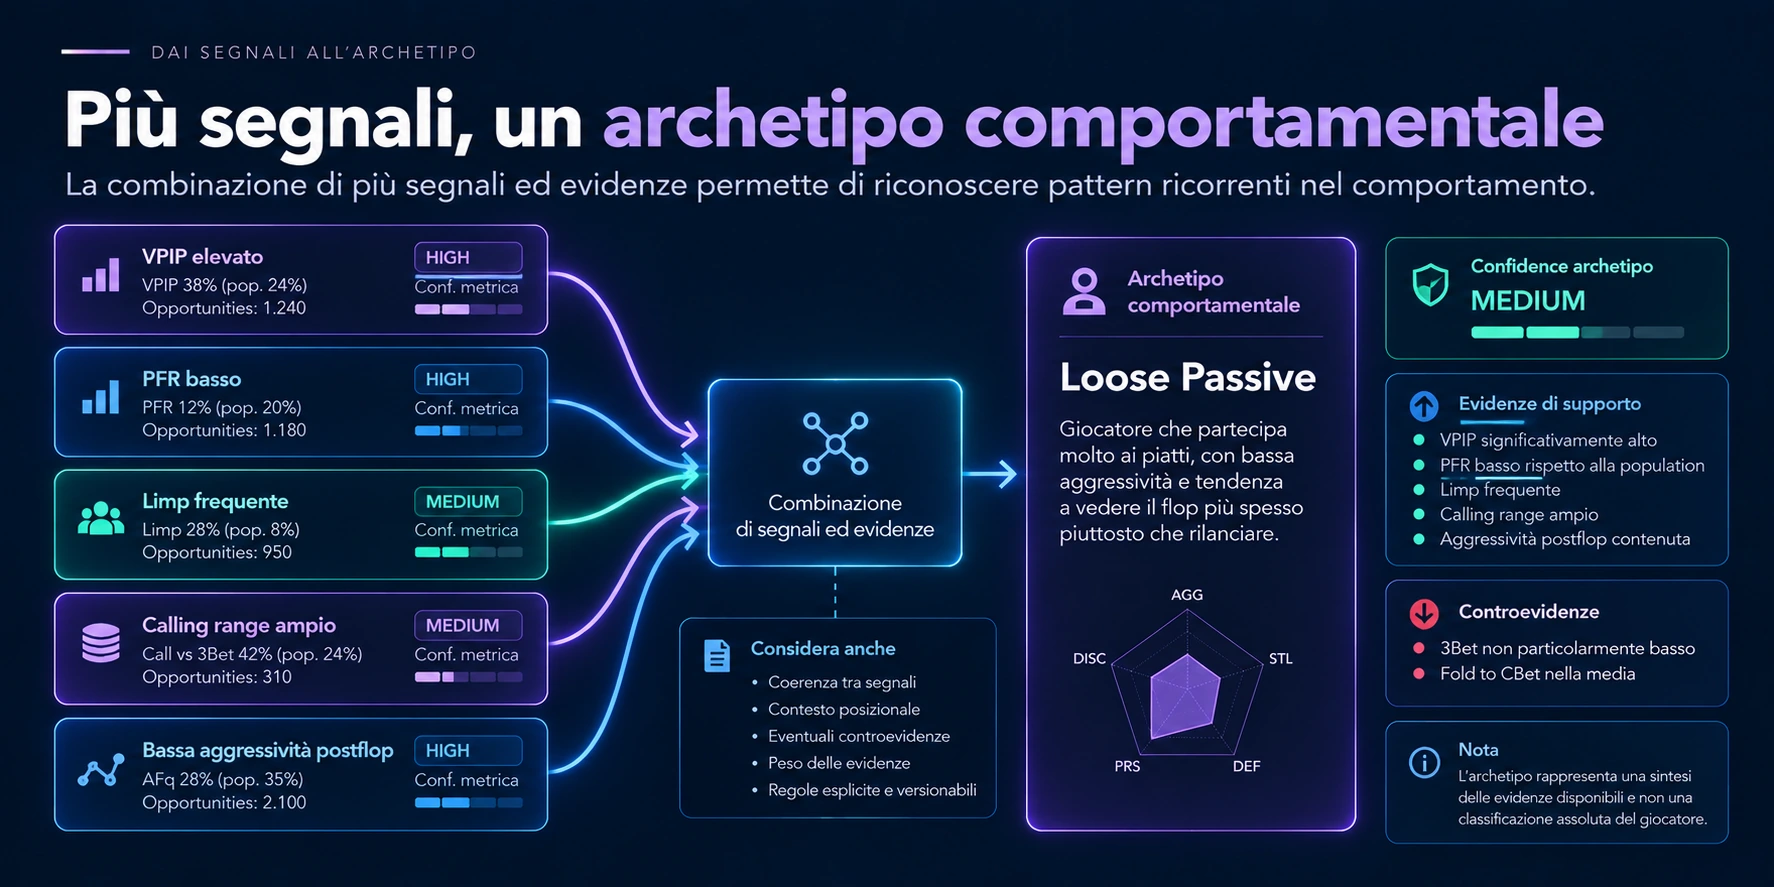
Immaginiamo di osservare contemporaneamente:
- VPIP elevato;
- PFR relativamente basso;
- limp frequente;
- calling range ampio;
- aggressività postflop contenuta.
Ogni elemento racconta qualcosa.
Ma insieme possono descrivere un pattern comportamentale più riconoscibile.
Da qui nasce il concetto di archetipo.
Per esempio:
Loose Passive
Ma anche qui l’etichetta non deve diventare una sentenza.
Un archetipo è una compressione informativa.
Serve a sintetizzare più segnali in una rappresentazione immediatamente leggibile.
Non significa:
“questo giocatore è definitivamente di questo tipo.”
Significa:
“le evidenze che abbiamo osservato sono attualmente compatibili con questo pattern comportamentale.”
Il rischio dell’overfitting comportamentale
Più regole aggiungiamo, più aumenta una tentazione.
Costruire interpretazioni estremamente specifiche.
Ma un motore che produce decine di archetipi e centinaia di micro-segnali rischia di ricreare esattamente il problema da cui siamo partiti.
Troppa informazione.
Solo spostata di livello.
L’obiettivo dell’intelligence layer non dovrebbe essere produrre il maggior numero possibile di conclusioni.
Dovrebbe essere produrre poche conclusioni utili e sufficientemente sostenute dalle evidenze.
È una forma di compressione.
Potremmo partire da:
100 metriche
e arrivare a:
5 segnali rilevanti
Non perché le altre 95 metriche siano inutili.
Ma perché, in quel momento, quei cinque segnali sono quelli che meritano attenzione.
Le regole devono essere esplicite
Un’altra scelta architetturale è stata evitare che la logica interpretativa si disperdesse nel codice.
Se un segnale esiste perché:
- una metrica supera una certa soglia;
- il campione minimo è soddisfatto;
- la distanza dalla population è significativa;
- non ci sono controevidenze sufficientemente forti;
queste condizioni dovrebbero essere riconoscibili.
Idealmente:
esplicite, versionabili e testabili.
Perché le interpretazioni cambiano.
Una soglia può essere raffinata.
Un benchmark può evolvere.
Una regola può risultare troppo aggressiva.
Un nuovo dataset può suggerire una lettura differente.
Se la logica di intelligence è esplicita, possiamo modificarla senza riscrivere la storia.
Persist facts, derive intelligence
Qui torna una decisione presa molto prima, nel layer di Data Engineering.
Persist facts, derive intelligence.
Nel database voglio conservare ciò che è accaduto:
- mani;
- giocatori;
- azioni;
- posizioni;
- risultati;
- eventi.
Statistiche, signals e archetipi sono invece interpretazioni.
Possono cambiare.
Se domani modifico la definizione di un segnale, non voglio dover modificare gli eventi storici.
Voglio poter ricalcolare l’intelligence partendo dagli stessi fatti.
Questa separazione permette al sistema di evolvere.
I fatti rimangono.
Le interpretazioni possono migliorare.
Explainability come requisito architetturale
A questo punto l’explainability diventa inevitabile.
Se mostro a un utente:
“High multi-street pressure”
devo poter spiegare:
- quali metriche hanno contribuito;
- quali benchmark sono stati utilizzati;
- quante opportunities erano disponibili;
- quale confidence avevano le metriche;
- quali evidenze sostengono il segnale;
- quali eventualmente lo contraddicono.
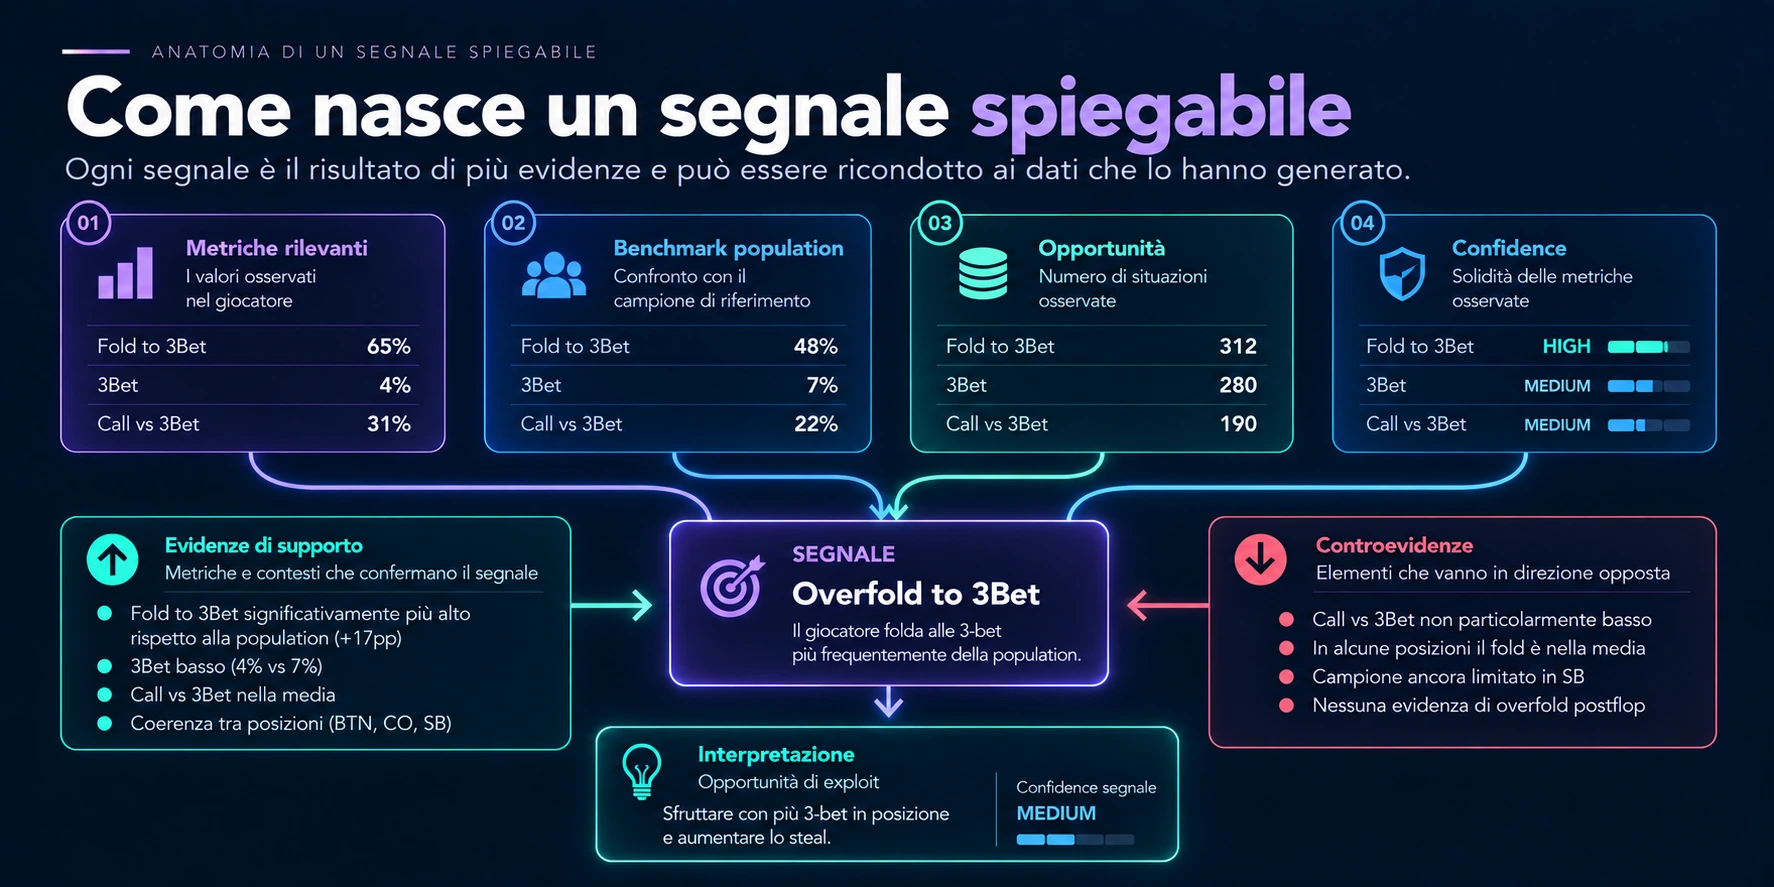
Questo non serve soltanto a creare fiducia nell’interfaccia.
Serve anche a me come sviluppatore.
Una conclusione spiegabile è:
- più facile da testare;
- più facile da debuggare;
- più facile da contestare;
- più facile da migliorare.
La trasparenza diventa quindi contemporaneamente una caratteristica del prodotto e uno strumento di engineering.
Intelligence non significa automatizzare la decisione
Arrivati qui, sarebbe facile fare un ultimo salto.
Se il sistema riesce a interpretare i comportamenti, perché non dirgli direttamente cosa fare?
Ma non era quello il mio obiettivo.
L’intelligence layer non doveva sostituire la decisione.
Doveva migliorare ciò che arriva prima della decisione.
Ridurre rumore.
Evidenziare anomalie.
Contestualizzare numeri.
Comprimere informazioni.
Mostrare evidenze.
Il risultato non è:
“fai questa azione.”
È qualcosa di più simile a:
“questo comportamento merita la tua attenzione, e queste sono le ragioni.”
È una distinzione che considero importante anche molto oltre questo progetto.
Dal dato alla decisione, senza saltare i passaggi
Guardando indietro, la pipeline è diventata progressivamente più lunga:
raw data
→ normalized facts
→ statistics
→ opportunities
→ confidence
→ population benchmark
→ signals
→ archetypes
→ intelligence
Ma nessuno di questi passaggi è decorativo.
Ognuno riduce una forma diversa di incertezza.
Il dato deve essere affidabile.
La statistica deve avere un campione interpretabile.
Il valore deve avere un contesto.
Il segnale deve avere evidenze.
L’interpretazione deve essere spiegabile.
Solo allora il sistema può davvero aiutare qualcuno a prendere una decisione migliore.
Ed è qui che, per me, analytics e intelligence smettono di essere sinonimi.
L’analytics mostra ciò che i dati contengono.
L’intelligence prova a rendere evidente ciò che merita attenzione.
Senza nascondere il percorso che ha portato fin lì.
Pubblicato originariamente su LinkedIn il 6 settembre 2026. Questa edizione fa parte degli Insights di Lead From Tech.