Quando si parla di AI nei progetti, una delle domande che sento più spesso è:
“Dove possiamo usare l’AI?”
È una domanda comprensibile.
Ma spesso è anche il punto di partenza sbagliato.
Perché rischia di trasformare la tecnologia in una soluzione alla ricerca di un problema.
Un progetto non dovrebbe adottare l’AI perché è disponibile.
Dovrebbe adottarla quando esiste una ragione concreta per farlo.
E quella ragione può nascere da due direzioni diverse.
Da un problema che vogliamo risolvere.
Oppure da una possibilità che prima non era realisticamente disponibile.
La parte interessante sta nel distinguere le due cose.
Due modi diversi per arrivare a un use case
Il primo approccio è quello più intuitivo.
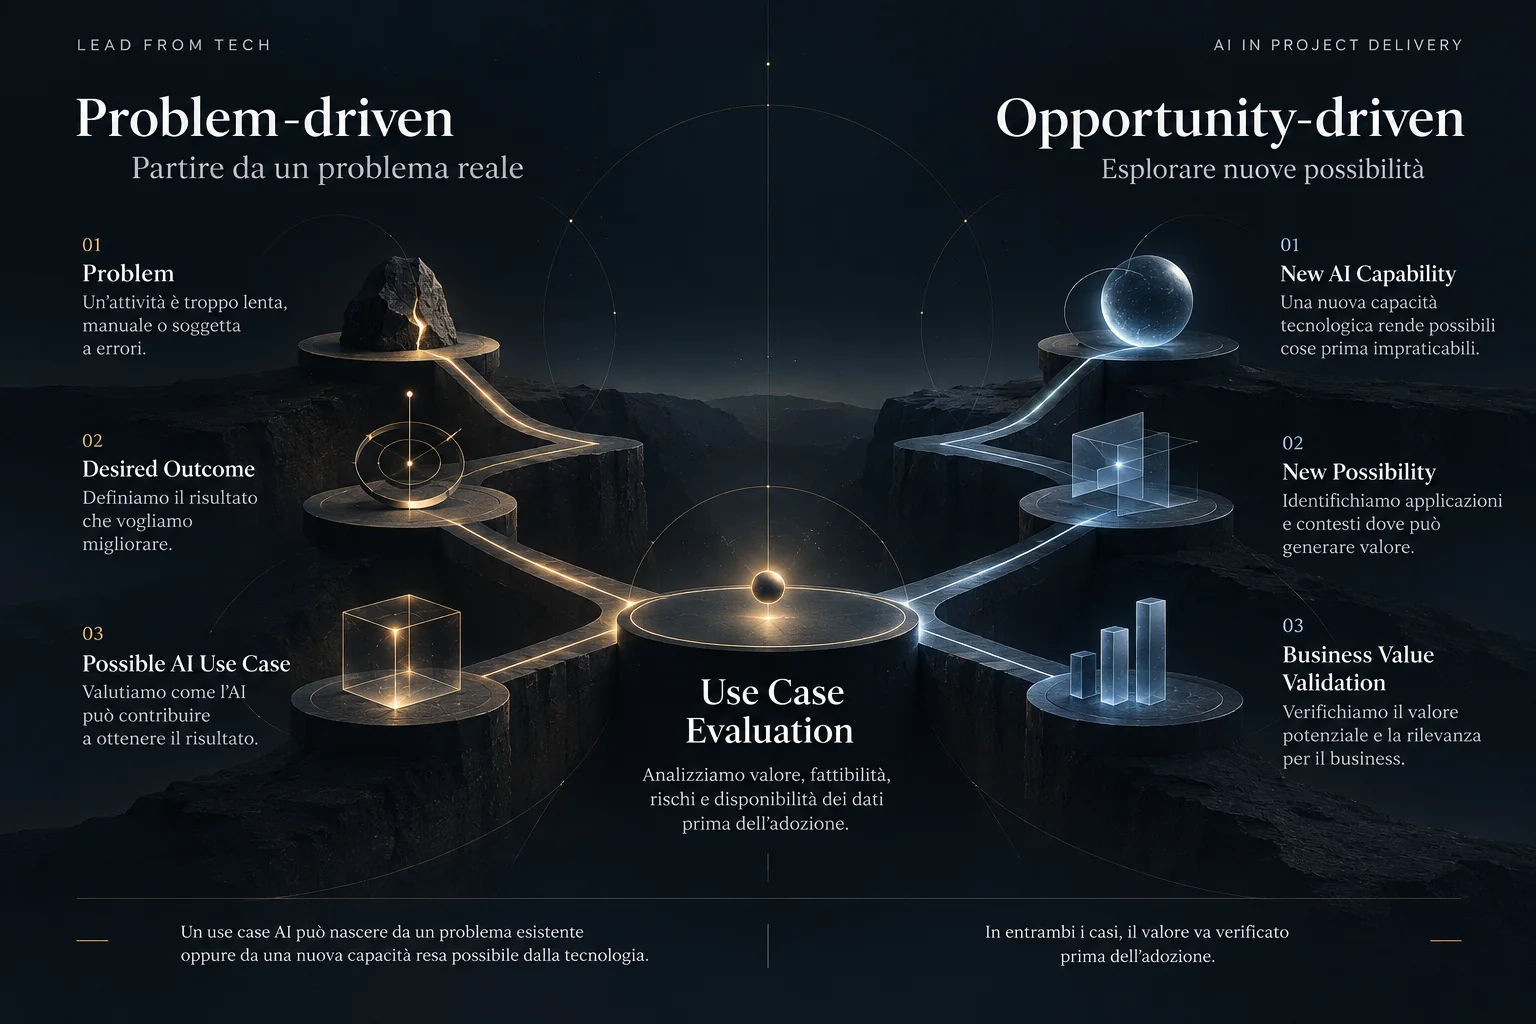
Problem-driven
Esiste già un problema.
Per esempio:
- tempi di risposta troppo lunghi;
- processi manuali ripetitivi;
- errori frequenti;
- grandi volumi di documentazione da analizzare;
- informazioni distribuite su troppe fonti;
- decisioni che richiedono troppo tempo;
- attività ad alto carico cognitivo.
In questo caso la sequenza è:
Problem → Desired Outcome → Possible AI Use Case
La tecnologia entra dopo.
Prima viene la domanda:
“Quale risultato vogliamo migliorare?”
Questo evita di confondere capacità tecnica e valore.
Ma esiste anche un secondo percorso.
Opportunity-driven
L’AI rende possibili cose che prima erano:
- troppo costose;
- troppo lente;
- troppo complesse;
- oppure semplicemente impraticabili.
In questo caso non stiamo necessariamente risolvendo un problema già formulato.
Stiamo scoprendo una possibilità nuova.
La sequenza diventa:
New AI Capability → New Possibility → Business Value Validation
È un approccio diverso.
E non va escluso.
Perché l’AI non serve solo a fare meglio ciò che già facciamo.
Può anche cambiare ciò che consideriamo possibile.
Un esempio: migliorare il controllo di un programma IT
Immaginiamo un programma composto da diversi progetti, ciascuno con un proprio responsabile, una pianificazione, rischi e avanzamenti da consolidare.
Il problema potrebbe essere la quantità di tempo necessaria a ricostruire lo stato complessivo del programma.
Un approccio problem-driven partirebbe da questa inefficienza, analizzando le fonti informative e valutando se l’AI possa contribuire a sintetizzare aggiornamenti, individuare incoerenze o evidenziare criticità.
Un approccio opportunity-driven, invece, potrebbe partire da una nuova capacità tecnologica: analizzare congiuntamente informazioni strutturate e documentazione progettuale, rendendo possibili forme di supporto decisionale prima troppo onerose.
I due percorsi possono condurre a soluzioni simili, ma nascono da ipotesi differenti.
E nessuno dei due dimostra, da solo, che l’AI sia la scelta corretta.
Se il problema dipende semplicemente da dati non aggiornati o da responsabilità poco chiare, introdurre un modello potrebbe aggiungere complessità senza risolvere la causa principale.
Il punto non è scegliere tra i due approcci
Problem-driven e opportunity-driven non sono alternativi.
Sono due porte d’ingresso.
Il problema nasce quando confondiamo:
possibilità
con
priorità.
Il fatto che l’AI possa fare qualcosa non significa che valga la pena farlo.
E allo stesso modo, il fatto che esista un problema non significa che l’AI sia necessariamente la soluzione migliore.
È qui che serve un filtro.
Quattro domande prima di chiamarlo “use case AI”
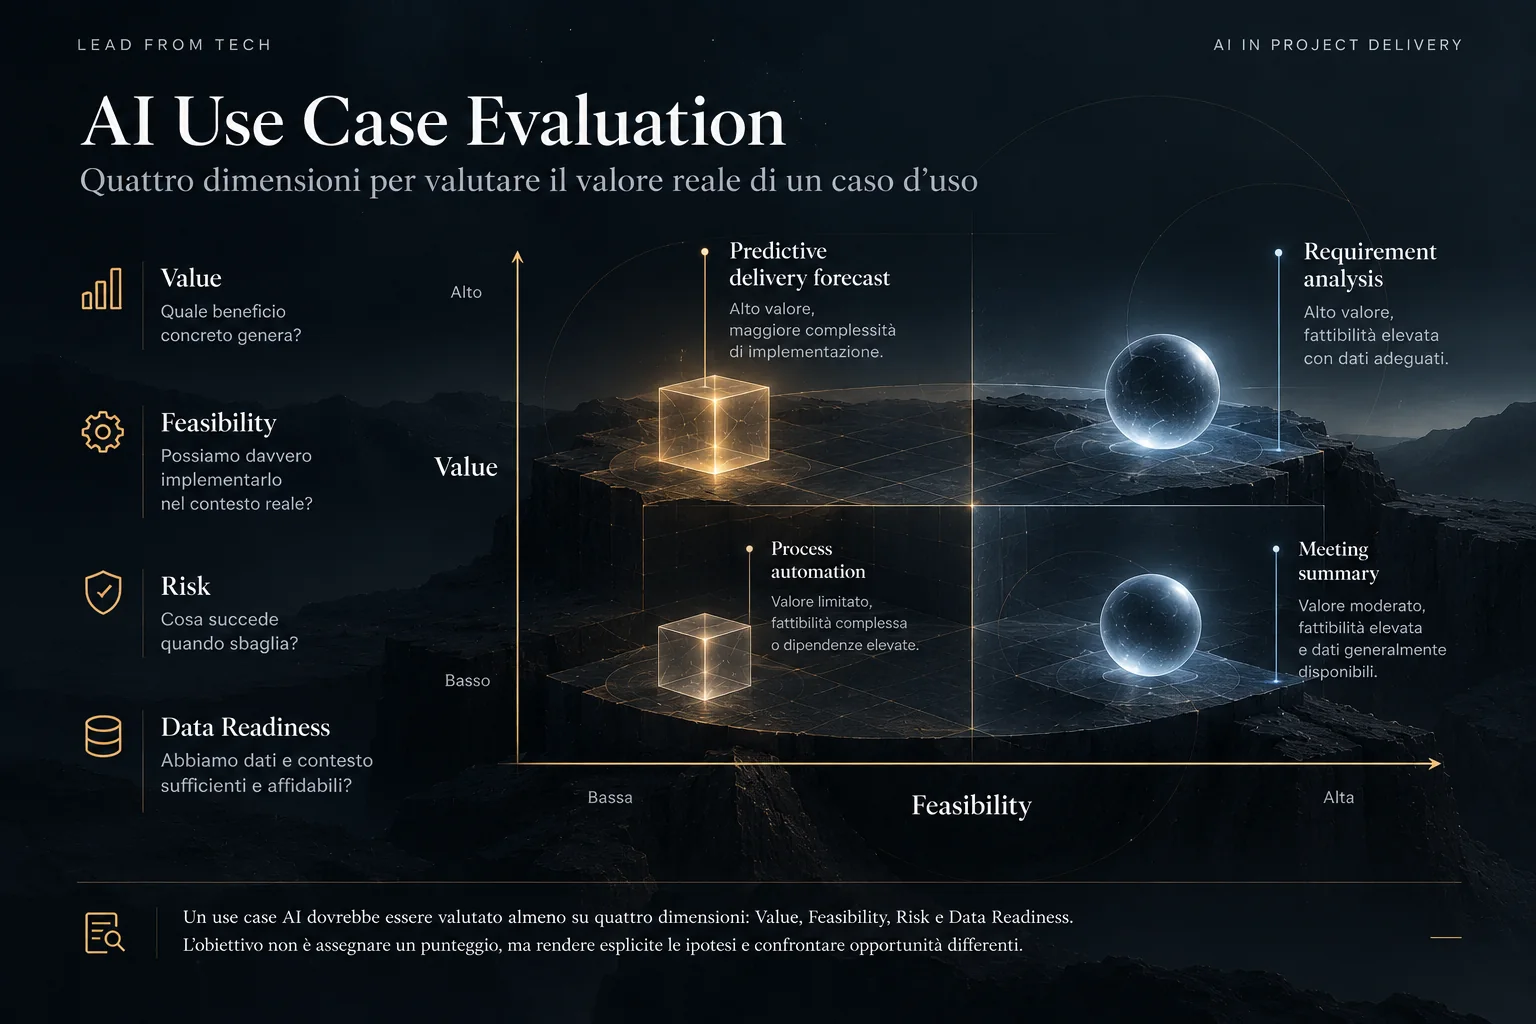
Per valutare un caso d’uso, trovo utile guardare almeno quattro dimensioni:
1. Value
Quale beneficio concreto genera?
Possiamo collegarlo a qualcosa di osservabile?
Per esempio:
- riduzione del cycle time;
- riduzione degli errori;
- aumento del throughput;
- riduzione del carico operativo;
- miglioramento della qualità;
- riduzione della latenza decisionale;
- migliore esperienza per utenti o operatori.
Se non sappiamo descrivere il valore atteso, probabilmente il use case non è ancora maturo.
2. Feasibility
Possiamo davvero implementarlo?
Non in una demo.
Nel contesto reale.
Questo significa considerare:
- sistemi esistenti;
- integrazioni;
- competenze disponibili;
- costi;
- tempi;
- scalabilità;
- vincoli infrastrutturali;
- dipendenze tecnologiche.
Molti use case sembrano semplici finché non devono entrare dentro processi e sistemi già esistenti.
3. Risk
Cosa succede quando sbaglia?
Questa è una delle domande più importanti.
Non tutti gli errori hanno lo stesso peso.
Un errore in una sintesi interna può essere corretto facilmente.
Un errore in una decisione automatizzata può avere conseguenze molto più serie.
Il rischio cambia in base a:
- impatto;
- reversibilità;
- sensibilità del dato;
- responsabilità;
- frequenza dell’errore;
- capacità di verifica umana.
Più alto è il rischio, più forte deve essere il controllo.
4. Data Readiness
Abbiamo davvero dati e contesto sufficienti?
Un modello potente non corregge automaticamente:
- dati incompleti;
- fonti incoerenti;
- informazioni obsolete;
- processi non standardizzati;
- ownership poco chiara.
Un use case può avere valore enorme e fattibilità tecnica elevata, ma fallire perché l’organizzazione non ha ancora una base informativa adeguata.
Le quattro dimensioni non costituiscono una formula automatica per decidere.
Servono a rendere esplicite le ipotesi e a confrontare opportunità differenti.
Un caso d’uso con valore potenziale elevato potrebbe richiedere prima un investimento sulla qualità dei dati. Un altro, meno ambizioso ma più semplice da integrare, potrebbe rappresentare una sperimentazione iniziale più sensata.
L’obiettivo non è assegnare un punteggio arbitrario a ogni idea.
È rendere comprensibile perché un’organizzazione decide di investire su un’opportunità invece che su un’altra.
Una demo che funziona non è ancora un progetto
Questo è probabilmente uno degli errori più comuni.
Una proof of concept può dimostrare che:
la tecnologia è capace di fare qualcosa.
Ma un progetto deve dimostrare molto di più.
Deve dimostrare che:
- il risultato è abbastanza affidabile;
- il processo può assorbirlo;
- gli utenti lo adotteranno;
- il costo è sostenibile;
- il rischio è accettabile;
- esiste ownership;
- esistono KPI;
- il comportamento può essere governato.
La distanza tra:
“funziona in demo”
e
“genera valore in produzione”
può essere enorme.
L’AI può essere utile anche quando non entra nella soluzione finale
C’è poi una distinzione che considero particolarmente importante.
Usare l’AI durante la progettazione non significa necessariamente costruire una soluzione che utilizzi AI in produzione.
Può essere usata per:
- esplorare alternative;
- analizzare requisiti;
- sintetizzare documentazione;
- simulare scenari;
- generare prototipi;
- confrontare opzioni;
- evidenziare rischi;
- accelerare discovery e design.
Il risultato finale potrebbe essere:
- un processo diverso;
- una semplificazione organizzativa;
- una nuova interfaccia;
- un’automazione deterministica;
- una modifica architetturale.
Senza alcun modello AI nella soluzione finale.
Questa distinzione è importante perché separa:
AI as design capability
da
AI as production component.
E le due cose non coincidono.
A volte la scelta corretta è non usare l’AI
Questa è probabilmente la decisione più difficile da prendere in un momento in cui l’AI genera molta pressione all’adozione.
Ma alcuni problemi hanno già soluzioni:
- più economiche;
- più affidabili;
- più comprensibili;
- più facili da governare.
Se una regola deterministica risolve bene il problema, non è necessario sostituirla con un modello probabilistico.
Se il collo di bottiglia è organizzativo, l’AI potrebbe non essere la priorità.
Se i dati sono insufficienti, forse il primo investimento deve essere sul dato.
Se il processo è incoerente, accelerarlo potrebbe semplicemente produrre incoerenza più velocemente.
Non usare l’AI può essere una decisione tecnologicamente matura.
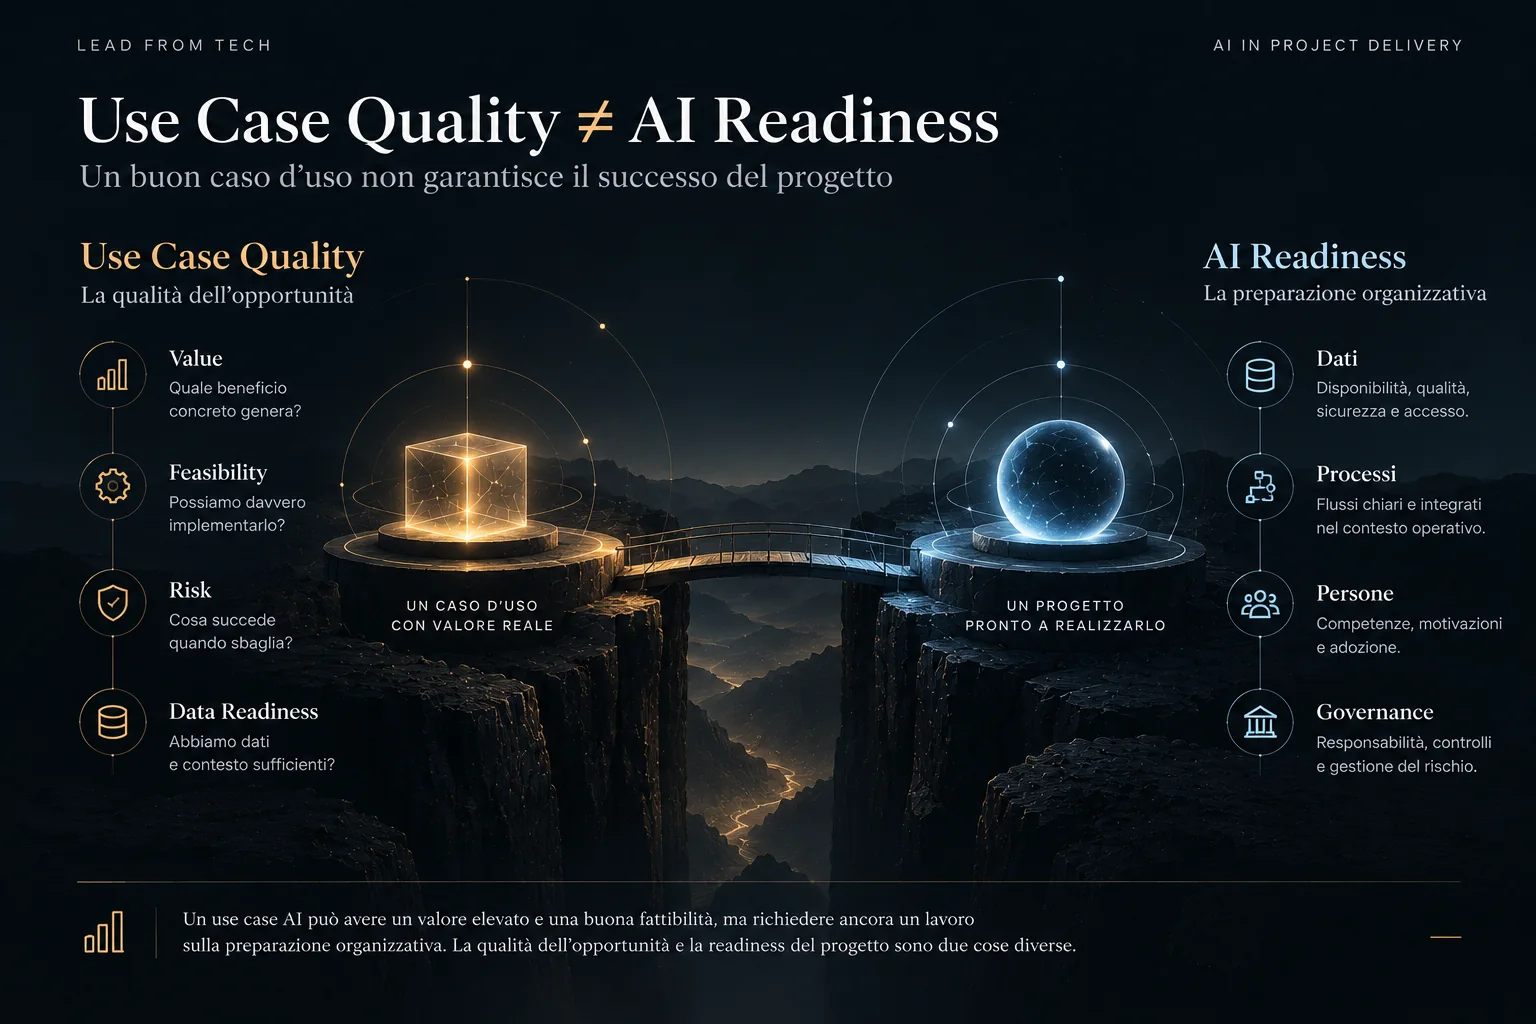
Un use case forte non significa che il progetto sia pronto
Esiste poi un secondo livello.
Possiamo avere:
- alto valore;
- buona fattibilità;
- rischio gestibile;
- dati apparentemente adeguati.
E comunque non essere pronti.
Perché il progetto o l’organizzazione possono non avere ancora:
- ownership chiara;
- policy;
- competenze;
- modalità di escalation;
- processi di validazione;
- monitoring;
- responsabilità definite.
Quindi:
Use Case Quality ≠ AI Readiness
Sono due valutazioni diverse.
La prima risponde a:
“Vale la pena farlo?”
La seconda:
“Siamo nelle condizioni di farlo bene?”
La vera domanda cambia
A questo punto la domanda iniziale:
“Dove possiamo usare l’AI?”
diventa qualcosa di più utile:
“Dove l’AI può generare abbastanza valore da giustificare complessità, rischio e cambiamento?”
È una domanda meno entusiasmante.
Ma molto più utile.
E soprattutto sposta la conversazione dalla tecnologia alla decisione.
Dal progetto alla governance
Più approfondisco questi temi, più trovo interessante che le decisioni più importanti sull’AI siano spesso poco tecnologiche.
Riguardano priorità, responsabilità, processi, dati, rischio, adozione e misurazione.
Sono aspetti che sto approfondendo anche nel percorso CPMAI, ma che ritrovo soprattutto nella pratica quotidiana della gestione dei progetti e dei programmi IT.
Perché il punto non è soltanto capire cosa l’AI sia in grado di fare.
È decidere cosa vale la pena fare, in quali condizioni e con quali responsabilità.
Una buona governance dell’AI comincia prima della scelta del modello.
Comincia quando siamo capaci di distinguere un’opportunità tecnologica da una priorità di business.
E quando siamo disposti a riconoscere che, in alcuni casi, la decisione migliore è non utilizzare l’AI.
Questo è il punto di partenza del nuovo filone di approfondimenti su Lead From Tech.
Nel prossimo Insight affronteremo una distinzione altrettanto importante:
Un progetto può avere un ottimo use case AI e non essere ancora pronto per realizzarlo?
La risposta, molto spesso, è sì.
Ed è qui che entra in gioco il tema della AI Readiness.