Nel precedente Insight, Data Engineering: quando il problema non è raccogliere dati, ma renderli affidabili, sono arrivato a una conclusione apparentemente semplice:
prima dell’intelligence viene la fiducia nel dato.
Ma avere un dato corretto non significa ancora poterlo interpretare correttamente.
Una statistica può essere calcolata senza errori, essere matematicamente impeccabile e risultare comunque fuorviante.
Perché un numero, da solo, racconta solo una parte della storia.
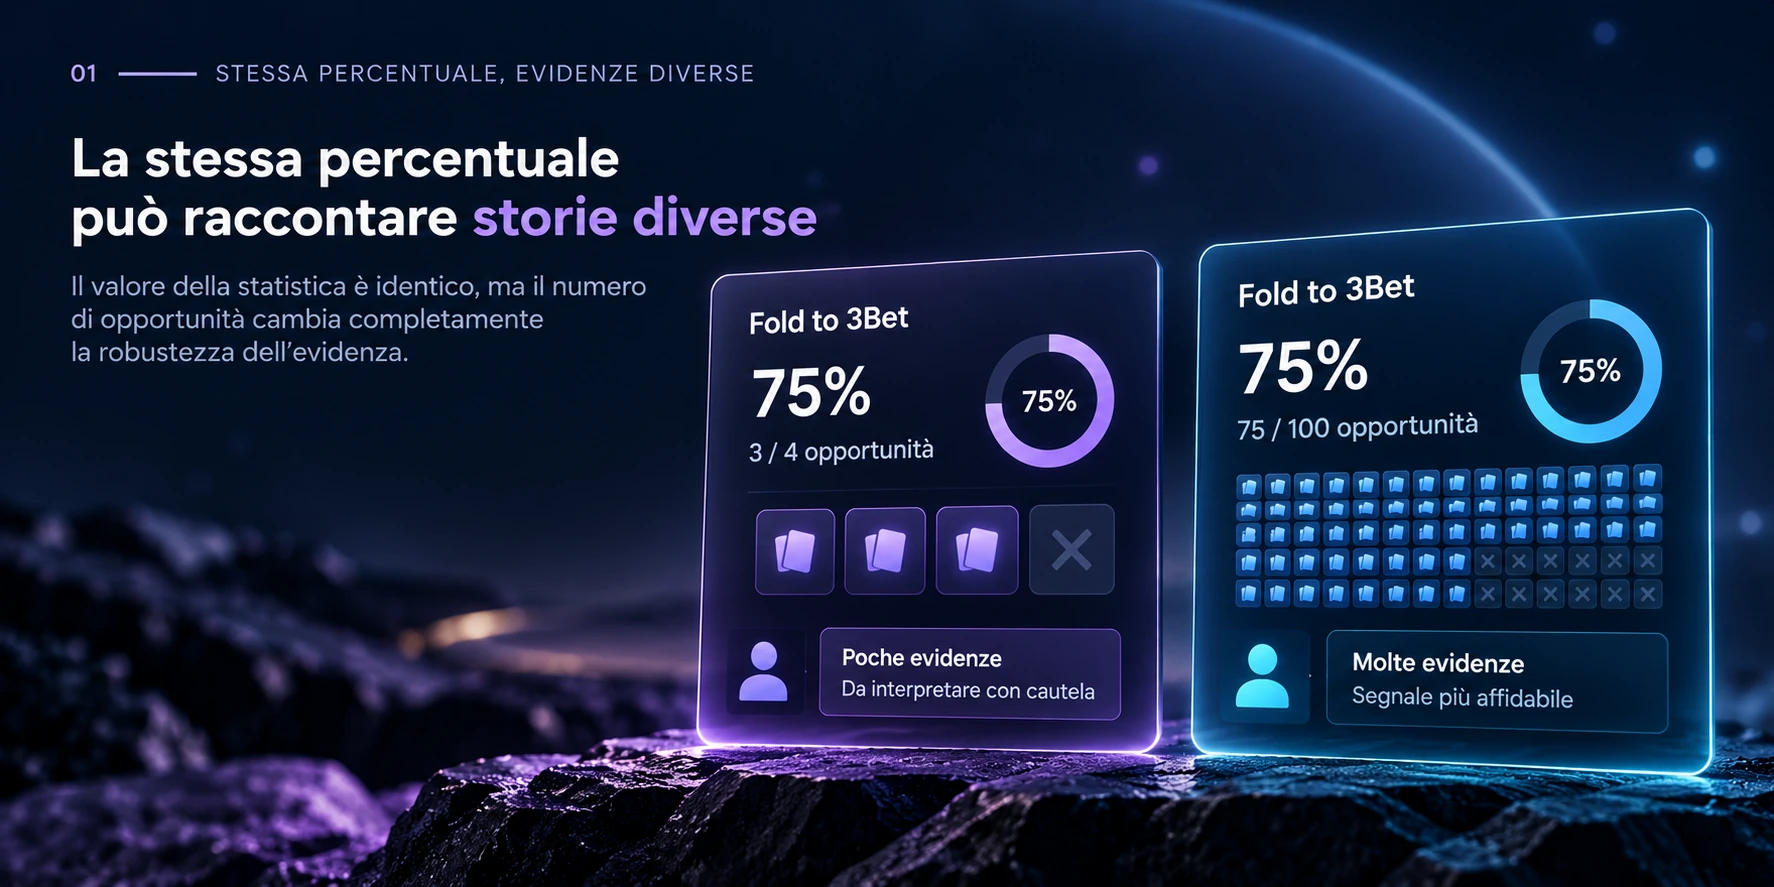
Se un giocatore ha un Fold to 3Bet del 75%, la tentazione è immediata:
“folda troppo alle 3-bet.”
Ma 75% può significare:
3 fold su 4 opportunità
oppure:
75 fold su 100 opportunità
La percentuale è identica.
L’informazione che possiamo ricavarne non lo è affatto.
Una statistica è una relazione, non un numero isolato
Quando iniziamo a costruire un sistema di analytics è naturale concentrarsi sulle percentuali.
VPIP.
PFR.
3Bet.
Fold to 3Bet.
CBet.
Fold to CBet.
Steal.
Blind defense.
Ma quasi nessuna di queste metriche nasce semplicemente contando quante volte è accaduto qualcosa.
Nasce dal rapporto tra:
eventi osservati / opportunità reali
Prendiamo il Fold to 3Bet.
Non ha senso dividerlo per tutte le mani giocate.
E nemmeno per tutte le volte in cui il giocatore ha fatto open raise.
L’opportunity esiste soltanto quando si verifica la sequenza necessaria:
- il giocatore apre;
- un avversario effettua una 3-bet;
- l’azione torna al giocatore;
- il giocatore ha realmente la possibilità di decidere.
Solo in quel momento possiamo osservare se folda, chiama o rilancia.
Quindi la statistica non è semplicemente:
numero di fold
ma:
fold / opportunità di foldare a una 3-bet
Questa distinzione sembra banale.
In realtà cambia completamente il modo in cui deve essere progettato il motore statistico.
Le opportunities sono parte del dominio
Se voglio sapere quante volte un evento è avvenuto, posso contare.
Se voglio sapere con quale frequenza un giocatore compie una certa scelta, devo prima capire quante volte avrebbe potuto compierla.
E questo richiede conoscenza del dominio.
Per calcolare una CBet al flop, per esempio, non basta trovare una bet al flop.
Bisogna sapere chi era l’aggressore preflop, se ha raggiunto il flop, se ha avuto la possibilità di puntare e quale azione ha effettuato.
Per calcolare Fold BB vs Steal bisogna identificare una situazione di steal, verificare che il giocatore fosse effettivamente nel big blind e ricostruire quale decisione abbia preso.
Quindi l’opportunity non è un dettaglio statistico aggiunto alla fine.
È una proprietà che emerge dalla ricostruzione degli eventi del dominio.
Ed è uno dei motivi per cui nel layer precedente ho scelto di conservare eventi atomici anziché conclusioni già calcolate.
Se gli eventi sono disponibili, posso ricostruire non soltanto ciò che è successo.
Posso ricostruire anche ciò che avrebbe potuto succedere.
Il denominatore cambia il significato
Immaginiamo due giocatori.
Entrambi hanno:
Fold to CBet Flop = 80%
Il primo:
4 fold / 5 opportunities
Il secondo:
80 fold / 100 opportunities
Visualizzare soltanto:
80%
li rende apparentemente identici.
Visualizzare:
80% (4/5)
e
80% (80/100)
racconta immediatamente una storia diversa.
Non perché il primo dato sia necessariamente sbagliato.
Ma perché abbiamo molte meno evidenze per considerarlo rappresentativo del comportamento del giocatore.
Questo mi ha portato a una regola molto semplice:
ogni percentuale comportamentale dovrebbe poter essere ricondotta al proprio numeratore e al proprio denominatore.
Non soltanto per ragioni matematiche.
Anche per ragioni di trasparenza.
Sample size: quante osservazioni abbiamo davvero?
A questo punto entra in gioco il secondo concetto: sample size.
Nel poker il problema del campione è particolarmente evidente.
Possiamo avere migliaia di mani su un giocatore e pochissime osservazioni per una statistica specifica.
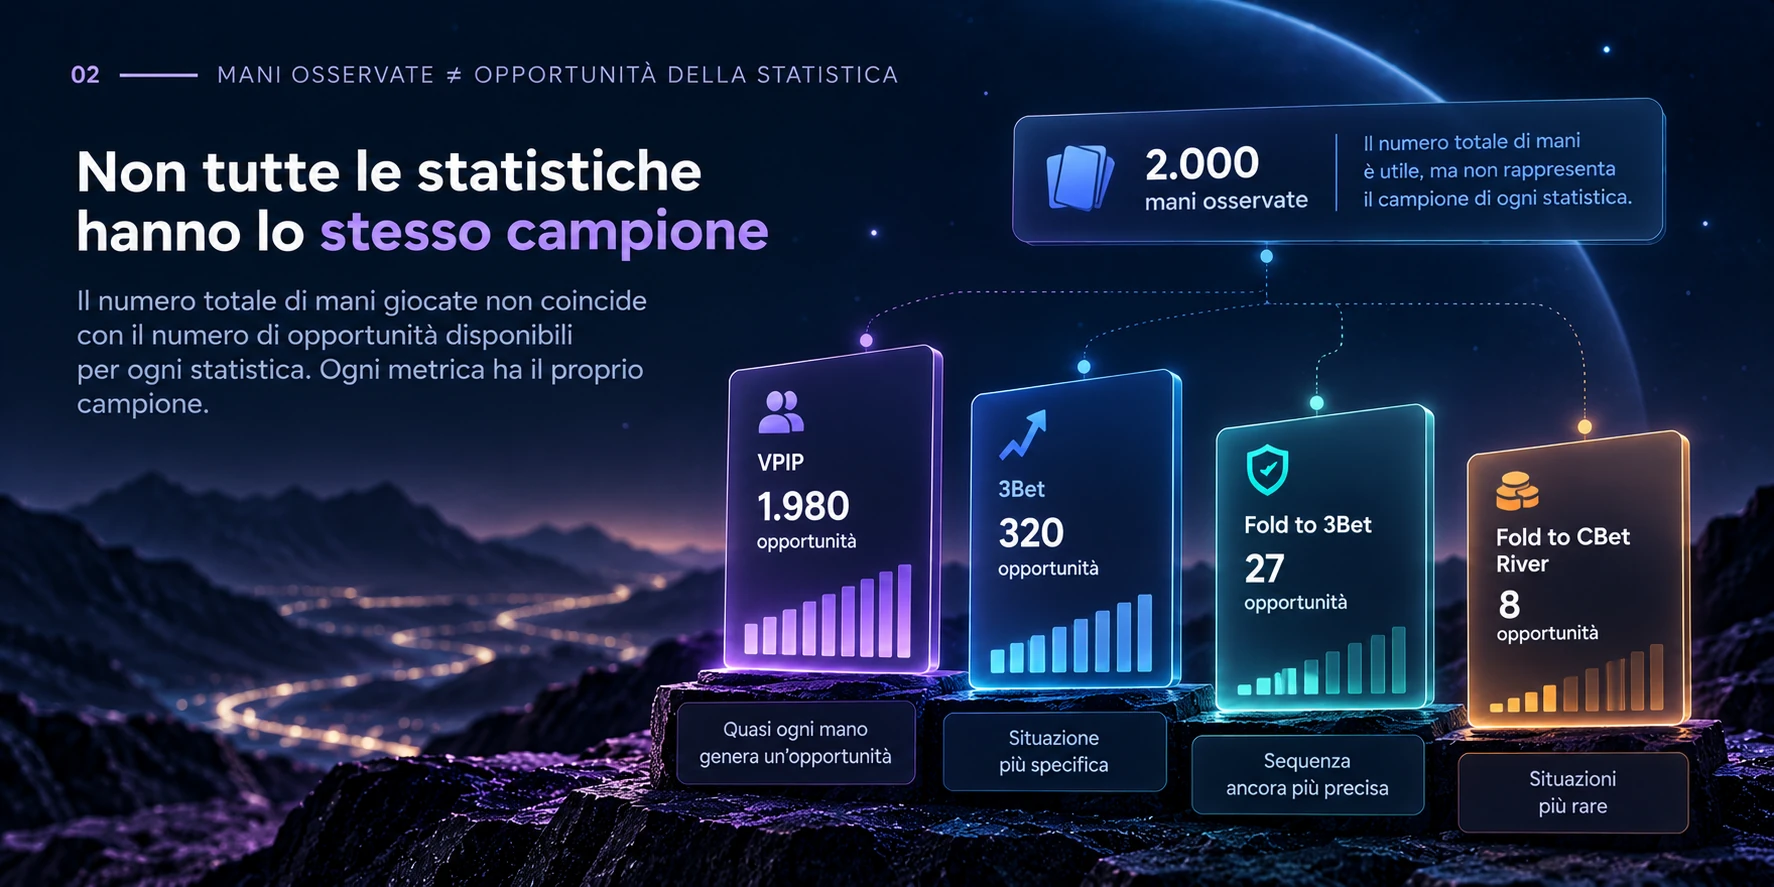
Perché il numero totale di mani non coincide con il numero di opportunità.
Un player può avere:
2.000 mani osservate
ma soltanto:
27 opportunità di Fold to 3Bet
e magari:
8 opportunità di Fold to CBet River
Questo significa che mostrare semplicemente:
“2.000 mani”
accanto a tutte le statistiche può produrre una falsa sensazione di solidità.
La sample size rilevante dipende dalla metrica.
Ogni statistica ha il proprio campione.
Più segmentiamo, più il campione si restringe
Il problema diventa ancora più interessante quando iniziamo a segmentare.
Una statistica aggregata può avere un campione ragionevole.
Ma se chiediamo:
- comportamento per posizione;
- comportamento contro una determinata posizione;
- comportamento per street;
- comportamento rispetto allo stack;
- comportamento in una specifica sequenza di azioni;
il numero di osservazioni disponibili diminuisce rapidamente.
È un trade-off inevitabile.
Più aumentiamo la precisione del contesto, più riduciamo la quantità di dati disponibili.
Possiamo esprimerlo così:
più specifica è la domanda, più piccolo tende a diventare il campione che può risponderle.
Questo significa che aggiungere filtri e segmentazioni non produce automaticamente insight migliori.
A volte produce semplicemente statistiche più precise nella definizione, ma molto più fragili nell’evidenza.
Dal sample size alla confidence
A questo punto avevo due informazioni:
- il valore della statistica;
- il numero di opportunità su cui era calcolata.
Ma per l’interfaccia non volevo costringere l’utente a reinterpretare ogni volta il denominatore.
Serviva un livello ulteriore.
Una rappresentazione sintetica della confidence.
Non come promessa di certezza matematica.
E nemmeno come giudizio assoluto sul giocatore.
Ma come indicazione di quanto il sistema consideri robusta l’evidenza disponibile per quella specifica lettura.
Concettualmente:
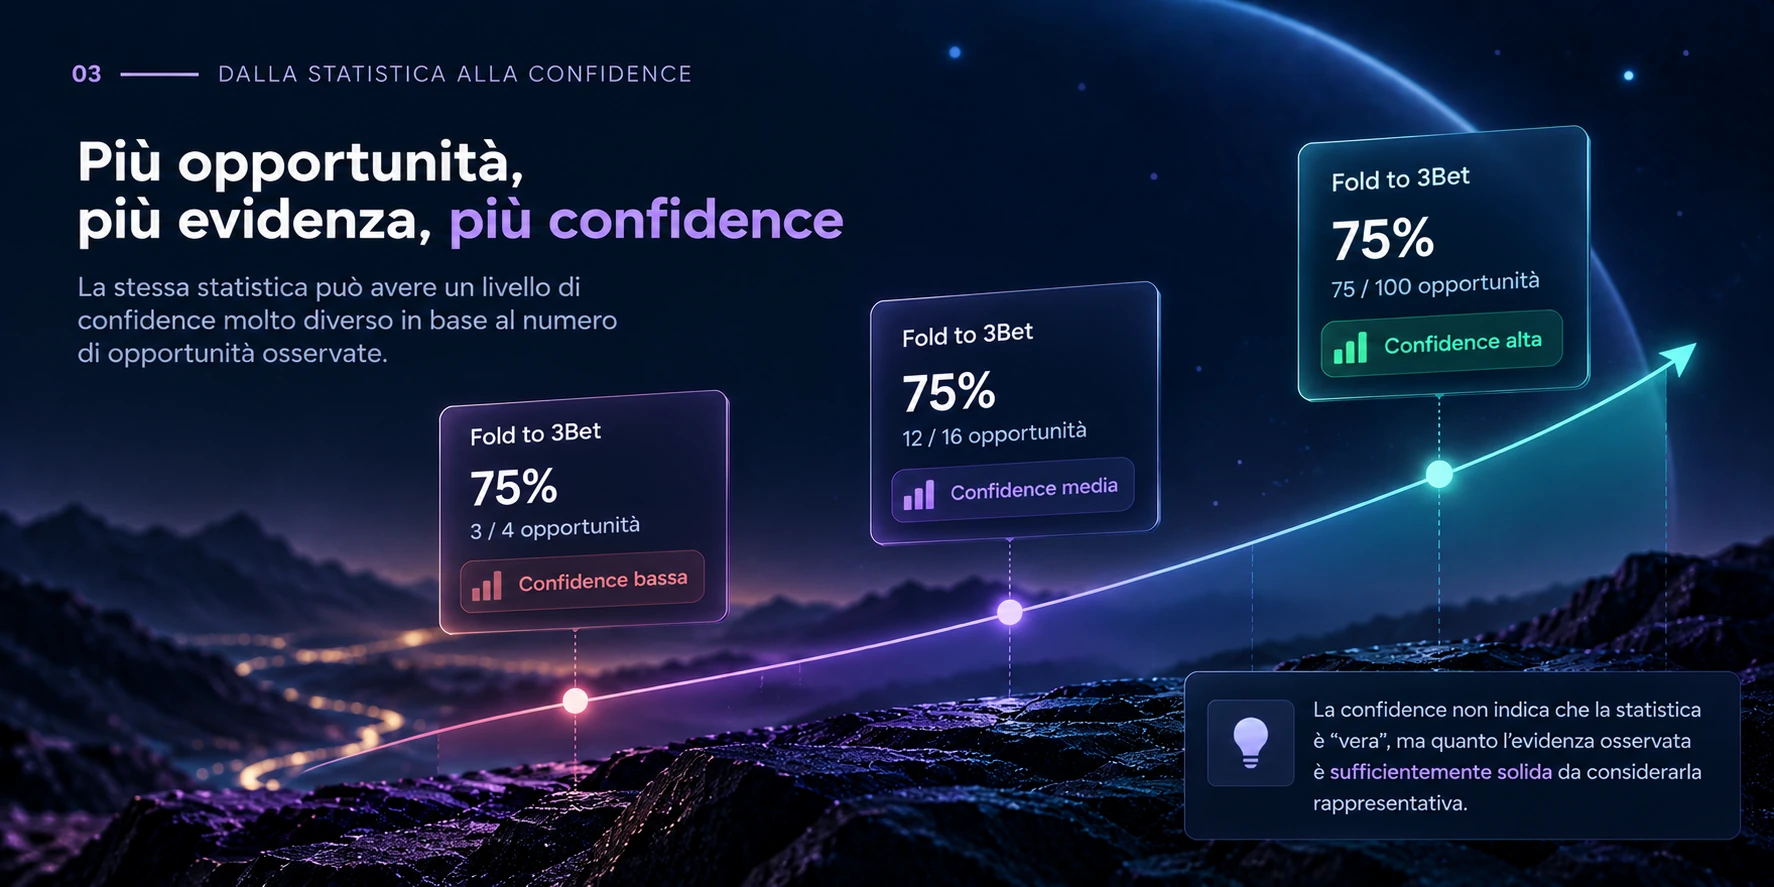
statistica + opportunities → confidence
Per esempio:
Fold to 3Bet: 75%
da solo comunica una percentuale.
Fold to 3Bet: 75% — 4 opportunities
aggiunge contesto.
Fold to 3Bet: 75% — confidence bassa
rende immediatamente visibile che quel valore va interpretato con cautela.
Confidence non significa verità
Questo punto per me è fondamentale.
Un livello di confidence alto non significa:
“questa lettura è sicuramente vera.”
Significa qualcosa di più limitato:
“abbiamo abbastanza evidenza osservata da considerare questa lettura più stabile rispetto a una basata su pochissime opportunità.”
Allo stesso modo, confidence bassa non significa che la statistica sia falsa.
Un giocatore che folda 3 volte su 4 alle 3-bet potrebbe realmente avere quella tendenza.
Semplicemente, il sistema non ha ancora abbastanza evidenza per trattarla allo stesso modo di una tendenza osservata decine o centinaia di volte.
Questa distinzione è importante perché impedisce al software di trasformare automaticamente:
un segnale
in
una conclusione.
Non tutte le statistiche convergono alla stessa velocità
C’è poi un’altra conseguenza.
Le opportunities non si presentano con la stessa frequenza per tutte le metriche.
VPIP e PFR producono osservazioni molto rapidamente perché quasi ogni mano contribuisce al campione.
Una 3Bet richiede già una situazione più specifica.
Fold to 3Bet richiede una sequenza ancora più precisa.
Una statistica sul river può richiedere che una mano attraversi molte condizioni prima di generare una singola opportunity.
Questo significa che non avrebbe senso trattare tutte le statistiche con la stessa aspettativa di campione.
Il sistema deve sapere che alcune metriche accumulano evidenza velocemente e altre lentamente.
Ed è qui che il problema smette di essere soltanto UI.
Diventa parte del modello analitico.
Dal singolo giocatore alla population
La scarsità di osservazioni individuali apre però un’altra possibilità.
Se sul singolo player ho poche opportunities, posso iniziare a confrontare quel comportamento con ciò che accade nella popolazione.
Non per sostituire il dato individuale.
Ma per contestualizzarlo.
Posso chiedermi:
- qual è la frequenza media osservata?
- quanto è distante questo player dalla population?
- quante osservazioni supportano il comportamento individuale?
- quante supportano il benchmark?
- la differenza è abbastanza consistente da diventare interessante?
Il passaggio da player statistics a population statistics cambia la natura del prodotto.
Non sto più soltanto descrivendo un giocatore.
Sto costruendo un riferimento rispetto al quale interpretarlo.
Ed è proprio qui che le statistiche iniziano ad avvicinarsi a qualcosa di diverso.
Un segnale.
Una UI responsabile deve mostrare anche l’incertezza
C’è infine una conseguenza di design che considero importante.
Se l’interfaccia mostra una percentuale molto evidente e nasconde il fatto che deriva da quattro osservazioni, sta comunicando più sicurezza di quella realmente disponibile.
Il problema non è matematico.
È comunicativo.
Per questo sample size, opportunities e confidence non dovrebbero essere considerati metadata secondari.
Sono parte dell’informazione.
Una buona interfaccia analitica non dovrebbe limitarsi a dire:
“questo è il numero.”
Dovrebbe aiutare a capire:
“quanto possiamo fidarci di questo numero nel contesto in cui lo stiamo usando?”
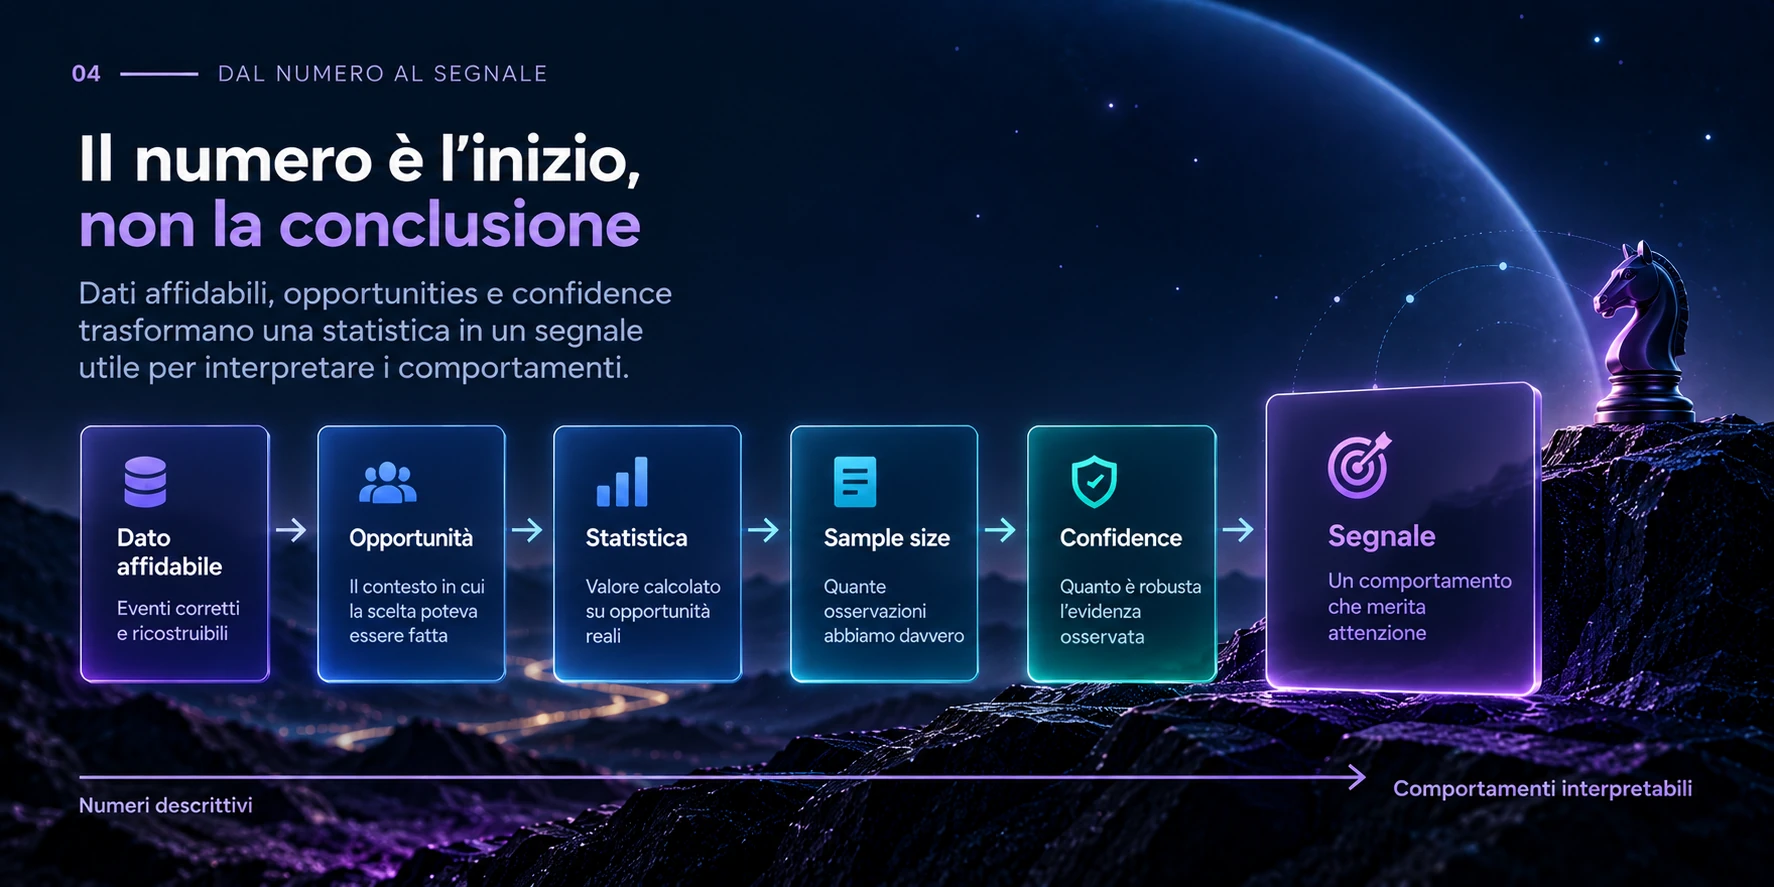
Il numero è l’inizio, non la conclusione
Questa fase del progetto mi ha fatto cambiare il modo in cui guardo alle statistiche.
All’inizio il problema sembrava essere calcolarle correttamente.
Poi è diventato evidente che servivano dati affidabili.
Poi che ogni percentuale doveva essere accompagnata dalle sue opportunities.
Poi che il campione doveva essere interpretato.
E infine che anche l’incertezza doveva diventare visibile.
La progressione, quindi, non è:
dato → statistica → decisione
È più simile a:
dato affidabile → opportunity → statistica → sample size → confidence → segnale
E il segnale non è ancora una decisione.
È qualcosa che merita attenzione.
Il passaggio successivo diventa quindi naturale.
Se il sistema riesce a combinare statistiche, opportunities, confidence e confronto con la population, può iniziare a fare qualcosa di più che mostrare numeri.
Può iniziare a interpretare comportamenti.
Ed è lì che il progetto comincia davvero a muoversi da statistiche a intelligence.
Pubblicato originariamente su LinkedIn il 30 agosto 2026. Questa edizione fa parte degli Insights di Lead From Tech.