Nel percorso che mi ha portato dal prototipo a un’architettura desktop locale, modulare e affidabile, ho separato presentation layer, application/domain layer e persistenza.
Ma un’architettura ben disegnata non basta.
Se i dati che la attraversano sono incompleti, duplicati o interpretati male, tutto ciò che viene costruito sopra diventa semplicemente un modo più sofisticato di produrre risultati sbagliati.
Ed è proprio qui che, nel progetto che sto sviluppando, il Data Engineering ha smesso di essere una fase accessoria ed è diventato parte centrale dell’affidabilità del prodotto.
Il dato grezzo non è ancora informazione
Il punto di partenza sono file testuali prodotti dalla piattaforma dopo ogni mano.
A prima vista sembrano semplici.
Contengono:
- identificativo della mano;
- torneo;
- livello;
- blind e ante;
- giocatori;
- stack;
- posizione;
- carte;
- azioni;
- board;
- showdown;
- vincitori;
- pot.
Ma il problema non è leggere delle righe.
Il problema è trasformare una rappresentazione testuale pensata principalmente per essere leggibile da un essere umano in un modello strutturato, consistente e interrogabile.
In altre parole:
text history ≠ structured data
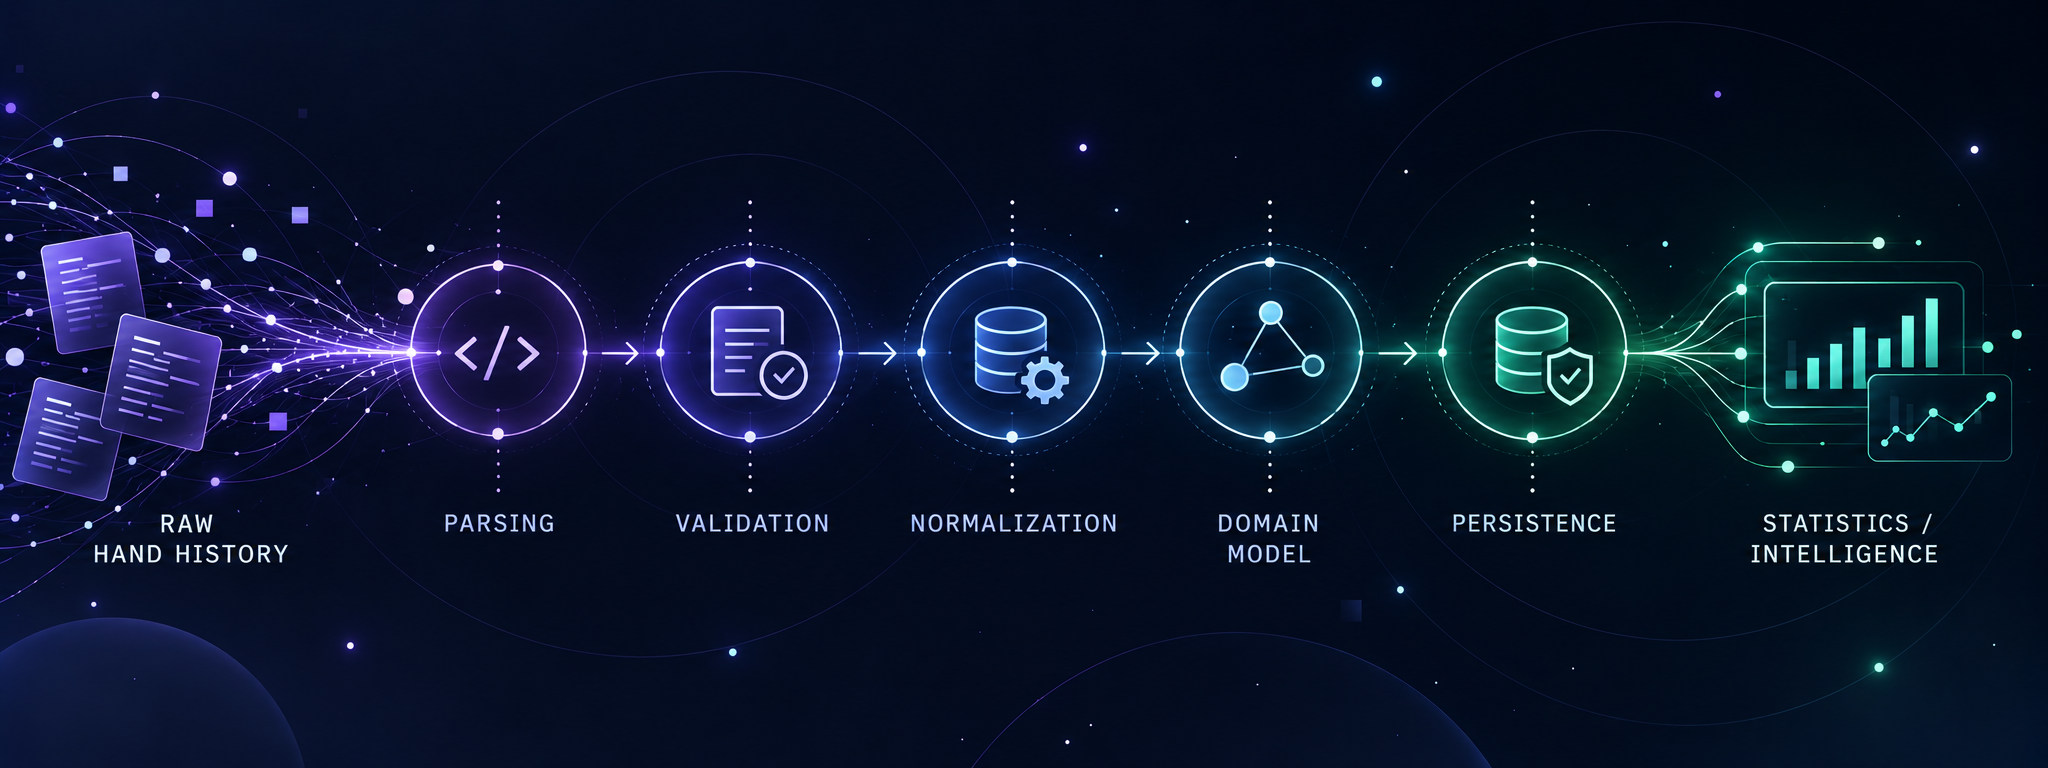
Tra i due estremi serve una vera pipeline di interpretazione.
Il parser non è universale: interpreta un formato specifico
All’inizio è facile pensare al parser come a una collezione di espressioni regolari.
Trova una riga.
Estrae qualche valore.
Passa alla successiva.
Funziona finché i dati sono semplici.
Poi arrivano i casi reali.
Una mano può terminare prima del flop. Può esserci uno showdown oppure no. Un giocatore può essere all-in. Può esserci un side pot. Una puntata può essere restituita perché nessuno la copre. Il vincitore può mostrare oppure non mostrare le carte.
Le strutture cambiano leggermente in base al torneo, alla fase e agli eventi della mano.
A quel punto il parser non sta più semplicemente leggendo testo.
Sta ricostruendo uno stato del dominio.
C’è però un aspetto ancora più importante.
Il parser sviluppato oggi è aderente alla tipologia di hand history scelta come formato di riferimento.
Questo significa che conosce:
- la struttura delle sezioni;
- il modo in cui vengono rappresentate le azioni;
- la sintassi degli importi;
- la descrizione delle street;
- il formato dei summary;
- il modo in cui vengono espressi winner, showdown, side pot e altri eventi.
Questa conoscenza è intenzionale.
Un parser affidabile non nasce cercando di interpretare genericamente “qualunque testo poker”.
Nasce comprendendo bene un formato preciso e trasformandolo in un modello di dominio coerente.
Per questo considero importante distinguere tra dominio poker e formato sorgente della hand history.
Il dominio applicativo può rimanere stabile.
Il parser, invece, è necessariamente legato alla struttura del dato in ingresso.
Se il dominio si amplia, anche il parser deve evolvere
Questa distinzione ha una conseguenza architetturale importante.
Se domani il prodotto dovesse supportare hand history provenienti da altre poker room, non mi aspetterei che il parser attuale le interpreti automaticamente.
Potrebbero cambiare intestazioni, naming delle sezioni, rappresentazione delle azioni, sintassi degli stack, descrizione dei blind, formato dei tornei, gestione dello showdown, struttura dei summary, casi particolari e metadata.
Quindi l’espansione del prodotto a nuove sorgenti non sarebbe semplicemente:
“aggiungiamo un altro file da importare”.
Richiederebbe l’evoluzione del layer di ingestion.
Il modello che considero più corretto è:
source-specific parser → normalized domain model
Ogni formato sorgente può avere la propria logica di interpretazione, ma tutti convergono verso la stessa rappresentazione interna.
Concettualmente:
Room A Hand History → Parser A
Room B Hand History → Parser B
Room C Hand History → Parser C
tutti verso:
Normalized Poker Domain Model
Questa è una distinzione fondamentale per mantenere evolvibile il prodotto.
Il parser deve essere specializzato. Il dominio deve cercare di rimanere indipendente dalla sorgente.
Il parser è quindi un interprete del dominio
Una riga che indica una puntata, per esempio, non è interessante soltanto per l’importo.
Bisogna sapere:
- chi ha agito;
- in quale street;
- quale tipo di azione ha effettuato;
- quale importo rappresenta;
- in quale sequenza temporale;
- rispetto a quali giocatori ancora attivi;
- con quale stato del pot.
È qui che parsing e domain modelling iniziano inevitabilmente a incontrarsi.
Ma l’obiettivo è evitare che il dominio erediti accidentalmente le peculiarità sintattiche della sorgente.
Il parser traduce.
Il dominio rappresenta.
Questa separazione diventa ancora più importante nel momento in cui aumentano le sorgenti supportate.
Separare parsing e persistenza
Una scelta importante è stata evitare che il parser scrivesse direttamente nel database.
Il flusso è invece concettualmente:
file → source parser → domain objects → persistence
Il parser deve sapere interpretare la hand history.
Non deve sapere come viene salvata.
La persistence deve sapere memorizzare una mano strutturata.
Non deve sapere come era scritta originariamente nel file.
Questa separazione ha un vantaggio enorme durante lo sviluppo.
Quando emerge una nuova variante di hand history posso intervenire sul parser senza modificare repository e database.
E quando cambia la struttura persistente posso lavorare sulla persistence senza contaminare le regole di parsing.
In prospettiva, la stessa separazione permetterebbe di aggiungere un parser per una nuova sorgente senza riscrivere tutto ciò che viene dopo.
È lo stesso principio architetturale che attraversa anche Dal prototipo al prodotto:
ogni componente deve conoscere il minimo indispensabile degli altri.
Normalizzare prima di analizzare
Il secondo problema arriva subito dopo il parsing.
Anche quando due elementi rappresentano concettualmente la stessa cosa, non è detto che arrivino nello stesso formato.
Date. Importi. Posizioni. Street. Tipi di azione. Metadata del torneo. Board. Risultati.
Tutto ciò che entra nel sistema deve essere trasformato in una rappresentazione coerente.
Perché l’analytics ha bisogno di poter assumere che:
la stessa informazione abbia sempre lo stesso significato e la stessa struttura.
Questa normalizzazione è importante già con una sola sorgente.
Diventa ancora più importante se in futuro ne vengono supportate più di una.
Due poker room possono descrivere la stessa azione in modo differente.
Il sistema deve però arrivare a rappresentarla allo stesso modo.
Questo significa che il vero contratto non è il testo sorgente. È il modello normalizzato interno.
Se una posizione viene interpretata diversamente in due mani, una statistica posizionale può risultare formalmente corretta e sostanzialmente sbagliata.
Se un raise e un all-in raise vengono classificati in maniera incoerente, il problema riemergerà più avanti nelle statistiche di aggressione.
Se una street viene attribuita male, l’errore può propagarsi su CBet, Fold to CBet, aggression frequency e decine di altre metriche.
Il punto importante è che l’errore più pericoloso non è sempre quello che provoca un’eccezione.
Spesso è quello che produce un dato perfettamente valido dal punto di vista tecnico, ma semanticamente errato.
Validation non significa solo “il file è leggibile”
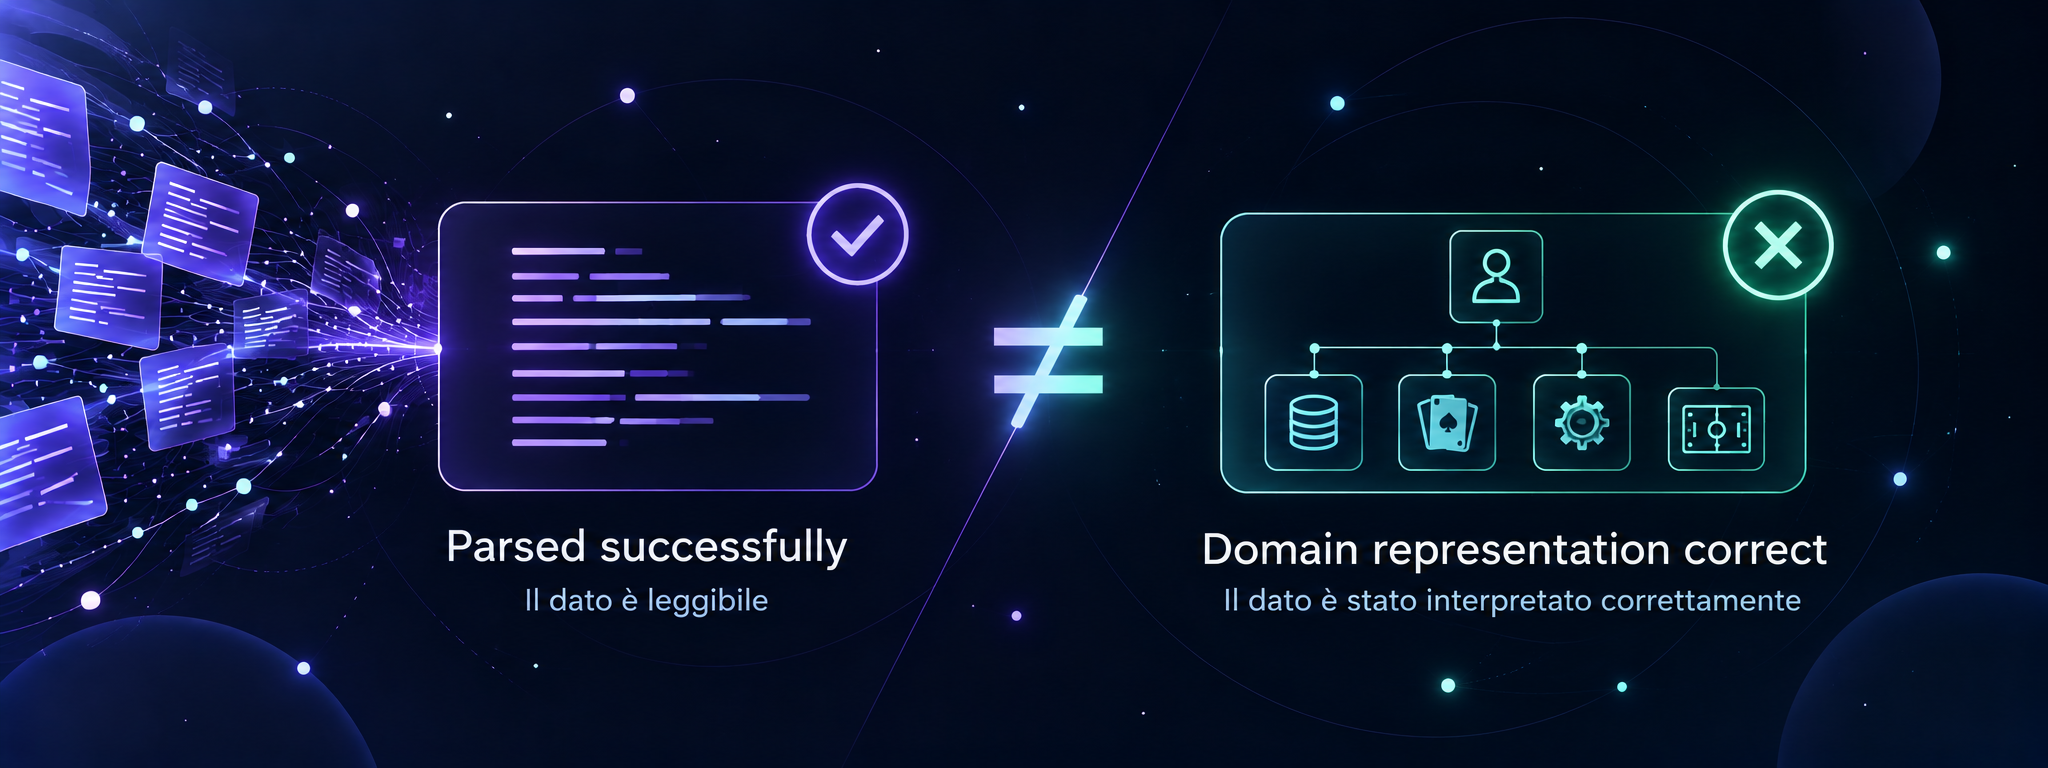
Per questo ho progressivamente separato due concetti:
parsing success
e
data correctness
Una mano può essere letta senza generare errori e contenere comunque una ricostruzione sbagliata.
La validazione deve quindi controllare invarianti del dominio.
Ad esempio:
- una mano deve avere un identificativo;
- deve avere giocatori coerenti;
- le azioni devono appartenere a street valide;
- il board deve rispettare la progressione flop/turn/river;
- i winner devono essere coerenti con la struttura della mano;
- gli importi devono poter essere rappresentati correttamente;
- le informazioni necessarie alle statistiche non devono essere perse durante la trasformazione.
Questo cambia molto il concetto di test.
Non sto più verificando soltanto:
“Il parser non va in errore?”
Sto verificando:
“La rappresentazione prodotta conserva davvero il significato della mano?”
Il problema invisibile dei duplicati
C’è poi un problema meno affascinante, ma fondamentale: la stessa mano può arrivare più di una volta.
L’utente può importare accidentalmente lo stesso file, una cartella già elaborata, copie dello stesso storico o file parzialmente sovrapposti.
Se ogni import producesse nuove righe, tutte le statistiche diventerebbero progressivamente inutilizzabili.
Una frequenza osservata due volte non diventa più affidabile.
Diventa semplicemente duplicata.
Per questo la deduplicazione non è un dettaglio dell’interfaccia di import.
È una proprietà del modello dati.
Nel database l’identità della mano viene protetta attraverso una chiave univoca basata sulla sorgente e sull’identificativo esterno della mano.
Concettualmente:
UNIQUE(source, external_hand_id)
Questa formulazione è importante anche in prospettiva multi-room: lo stesso identificativo numerico potrebbe teoricamente esistere in sorgenti differenti.
Il principio è:
l’idempotenza deve essere garantita dal sistema, non ricordata dall’utente.
Se importo due volte lo stesso dataset, il risultato finale deve rimanere consistente.
Dal file alle entità persistenti
Una mano non viene memorizzata come un enorme blob di testo.
Viene scomposta in elementi interrogabili.
Nel modello persistente esistono responsabilità distinte per:
- mano;
- giocatori della mano;
- azioni;
- vincitori;
- file importato.
Questo permette di fare una cosa fondamentale per tutto ciò che verrà dopo:
ricostruire le metriche partendo dagli eventi.
Una statistica come Fold to 3Bet non viene salvata dentro la mano.
Viene derivata da posizione, sequenza preflop, opportunity e azione del player.
Lo stesso vale per CBet, steal, blind defense, aggression e molte altre metriche.
Quindi la persistence non deve prevedere tutte le statistiche future.
Deve conservare abbastanza informazione atomica da permettere di calcolarle successivamente.
Questa è stata una delle decisioni più importanti del modello dati.
Conservare eventi, non conclusioni
È un principio che considero particolarmente utile:
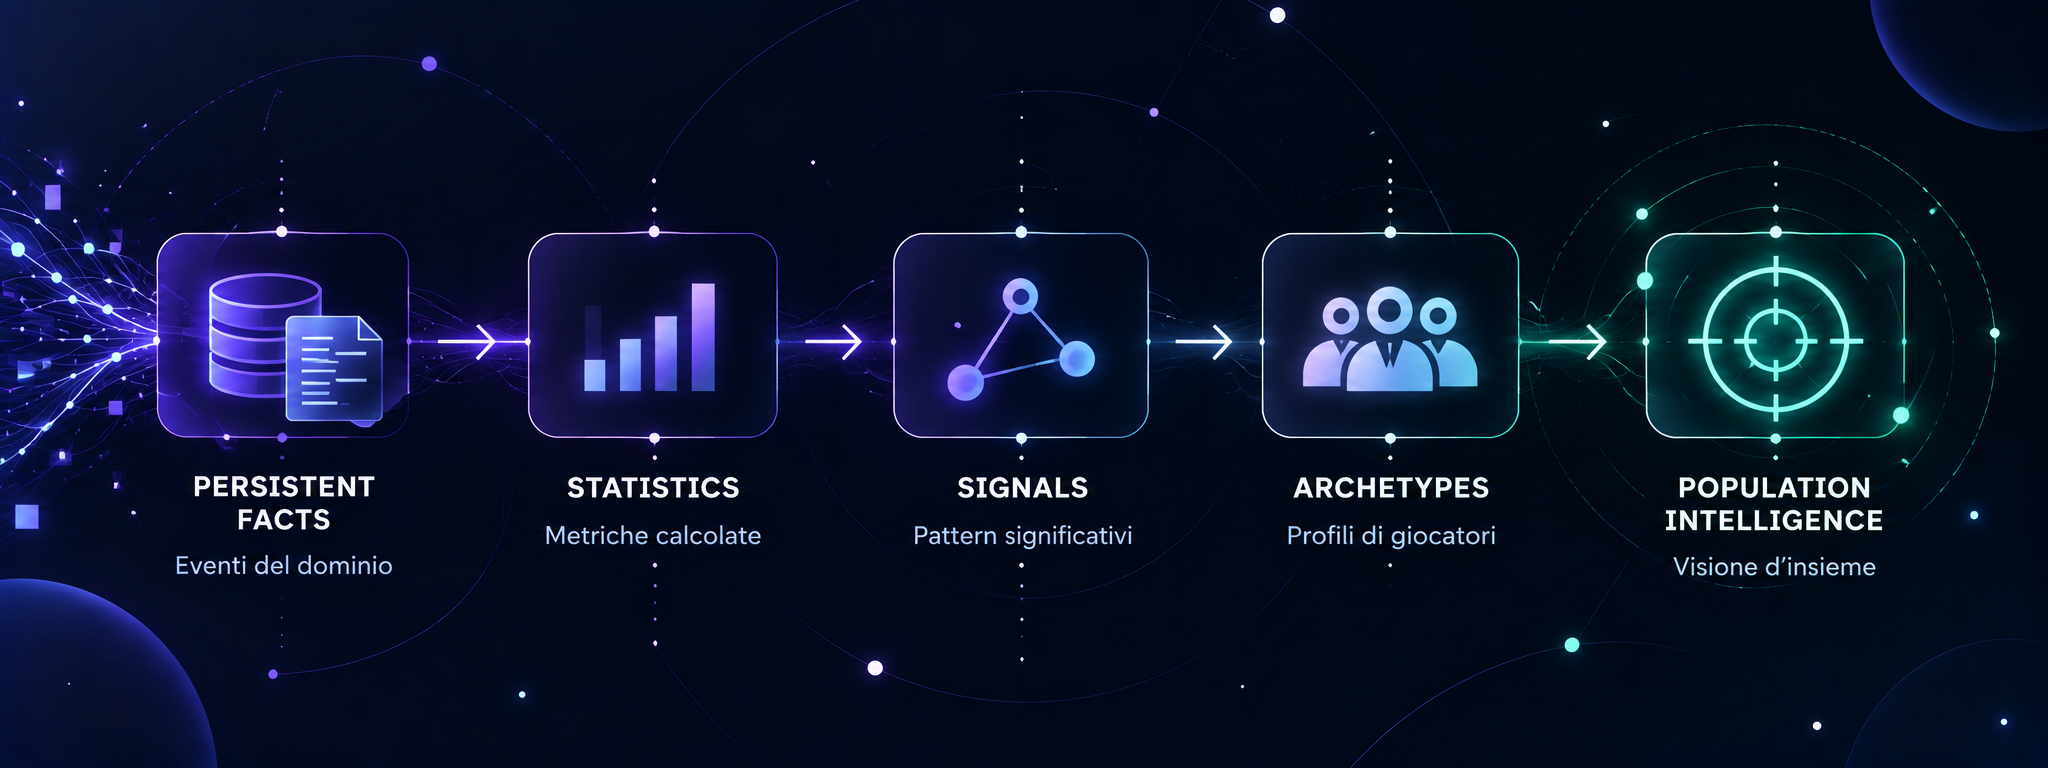
quando possibile, persistere fatti e derivare interpretazioni.
Una action è un fatto.
Un board è un fatto.
Un winner è un fatto.
Una posizione è un fatto ricostruito dal dominio.
“Questo giocatore overfolda” è invece un’interpretazione.
Se salvo soltanto l’interpretazione, domani diventa difficile cambiare formula, correggere una definizione, introdurre una nuova statistica, mostrare le mani di supporto, confrontare player e population oppure valutare confidence e sample size.
Se invece conservo gli eventi, posso ricalcolare le conclusioni.
Questa distinzione è fondamentale per un prodotto che vuole evolvere da statistics a intelligence.
Testare con dati reali
Un parser può avere una suite di unit test perfetta e fallire alla prima cartella reale.
Per questo, arrivato a un certo livello di maturità, ho aggiunto una verifica separata basata su hand history reali di torneo.
Il corpus utilizzato in quel momento comprendeva sei file reali provenienti dalla sorgente supportata.
Il risultato dell’ultima verifica parser era:
404 mani analizzate
404 parse con successo
0 fallimenti
Su un file da 117 mani il parser aveva completato l’elaborazione in circa 72 ms, con un throughput dell’ordine di 1.600 mani al secondo nell’ambiente di test.
La performance non era però la parte più importante di quel dato.
La parte importante era che il parser venisse verificato su materiale che non era stato costruito appositamente per far passare il test.
È una forma diversa di qualità.
Gli unit test proteggono i casi che conosco.
Il corpus reale aiuta a scoprire quelli che non avevo immaginato.
404/404 non significa “parser universale”
Questo è un altro aspetto importante.
Un parser che passa il 100% del corpus attuale non è necessariamente completo.
Significa:
interpreta correttamente tutte le varianti osservate fino a quel momento per il formato supportato.
Non significa:
“qualsiasi hand history prodotta da qualsiasi poker room potrà essere interpretata automaticamente.”
E non significa nemmeno che la stessa sorgente non possa introdurre in futuro nuove varianti.
Restano possibili nuove strutture di summary, descriptor di torneo non ancora osservati, formati particolari, eventi rari, storici provenienti da configurazioni diverse e differenze sintattiche tra poker room.
Per questo considero il parser un componente che deve essere monitorato ed evoluto insieme al dominio di input.
Quando cambiano le sorgenti supportate, cambia anche il problema di ingestion.
E questo non è un difetto dell’architettura.
È una conseguenza naturale del fatto che il dato sorgente è parte del contratto di integrazione.
L’affidabilità è una proprietà end-to-end
Alla fine, il punto che questo lavoro mi ha ricordato è che la qualità del dato non appartiene a un singolo componente.
È una catena.
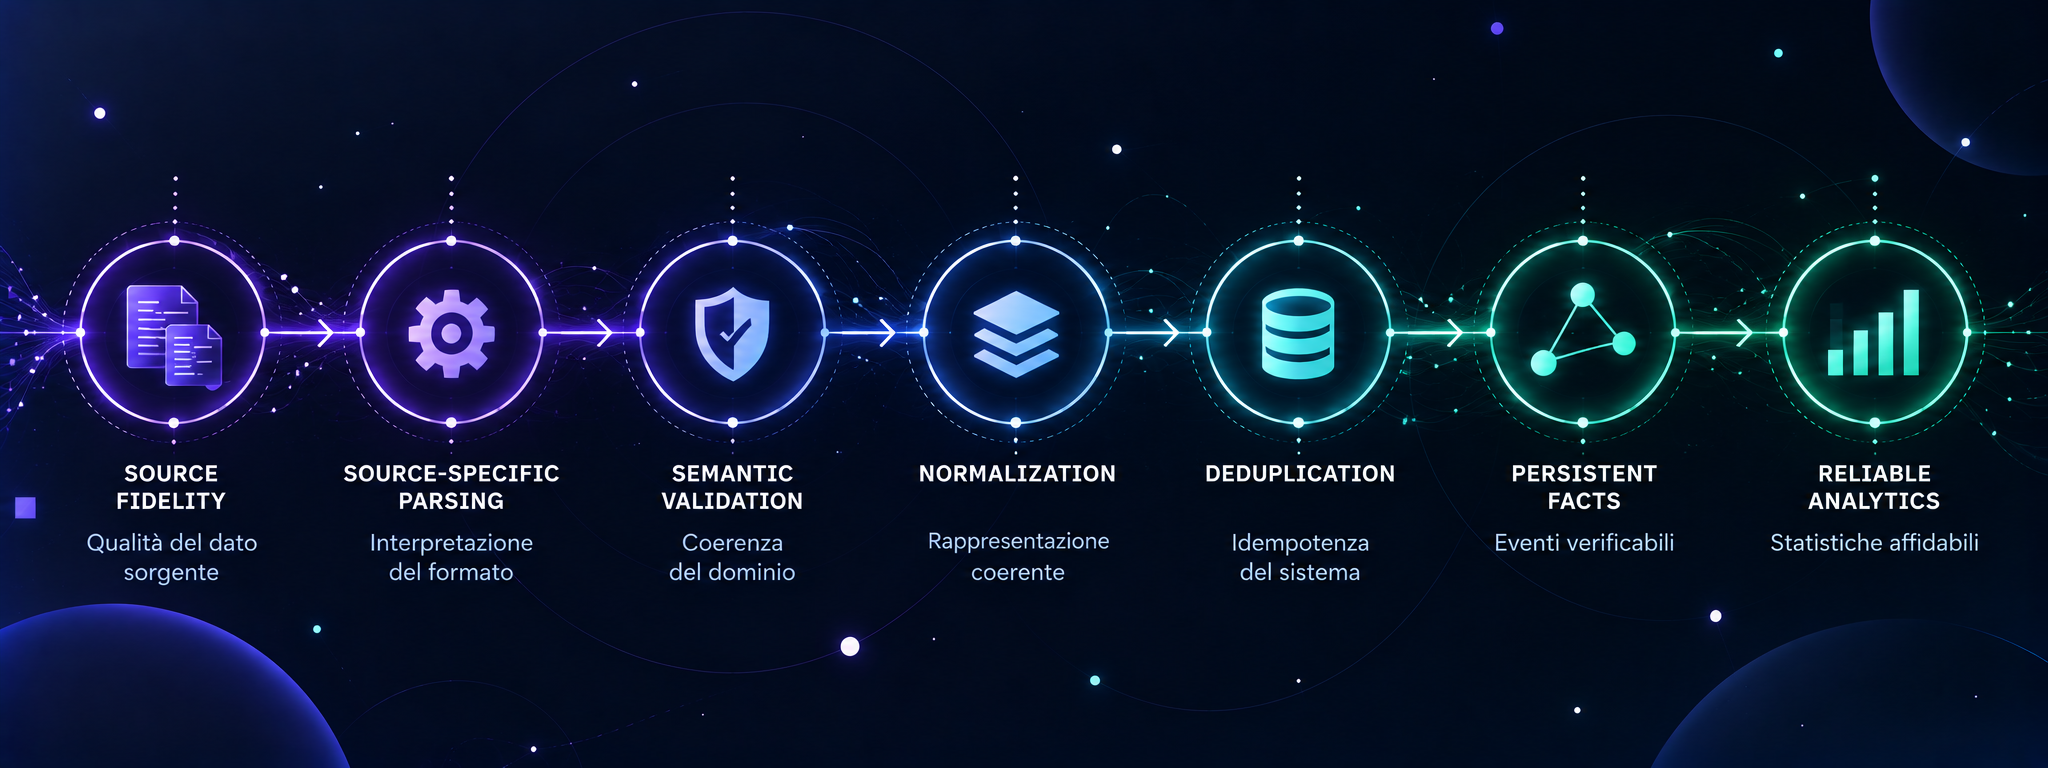
Se interpreto male la hand history:
→ salvo dati sbagliati.
Se salvo dati sbagliati:
→ calcolo statistiche sbagliate.
Se calcolo statistiche sbagliate:
→ genero pattern sbagliati.
Se genero pattern sbagliati:
→ qualsiasi livello di intelligence costruito sopra sarà sbagliato.
Più il sistema diventa sofisticato, più questo problema diventa importante.
Perché un algoritmo sofisticato applicato a dati sbagliati non corregge il problema.
Lo rende semplicemente più convincente.
Prima dell’intelligence viene la fiducia
È forse questa la conclusione più importante.
Quando costruiamo sistemi che trasformano dati in decision support, siamo naturalmente attratti dall’ultimo livello:
AI.
Pattern recognition.
Prediction.
Intelligence.
Ma il valore dell’ultimo livello dipende completamente dalla fiducia che possiamo avere nel primo.
Per questo, prima di costruire un motore capace di dire:
“Questo giocatore mostra questo comportamento”
voglio essere ragionevolmente certo che il sistema abbia interpretato correttamente chi fosse il giocatore, dove fosse seduto, cosa abbia fatto, quando lo abbia fatto, rispetto a quale opportunity e quante volte quella situazione si sia realmente verificata.
E voglio che questo resti vero anche quando, in futuro, il prodotto inizierà a ricevere dati da sorgenti differenti.
Perché estendere il numero di sorgenti supportate non significa soltanto aumentare il numero di file leggibili.
Significa preservare lo stesso livello di affidabilità attraverso parser diversi che convergono verso un unico modello di dominio.
Ma avere un dato affidabile non risolve ancora tutto.
Una statistica può essere matematicamente corretta e allo stesso tempo essere completamente fuorviante se non sappiamo quante opportunità l’hanno generata, quanto è grande il campione e quanta fiducia possiamo attribuirle.
È il passaggio successivo di questo percorso: quando il numero, da solo, non basta.
Pubblicato originariamente su LinkedIn il 23 agosto 2026. Questa edizione fa parte degli Insights di Lead From Tech.