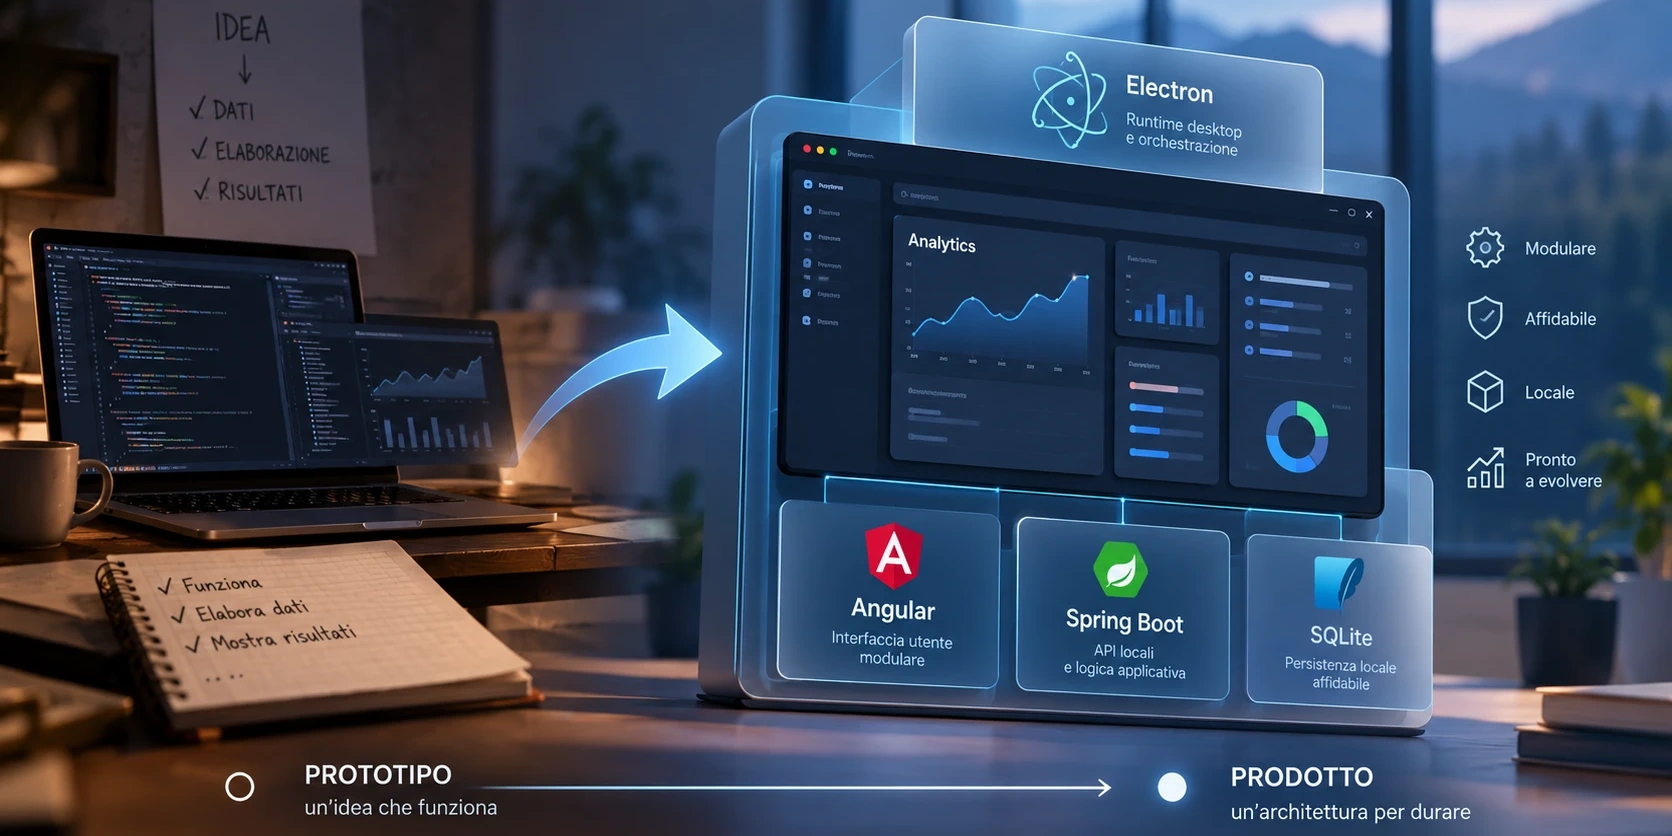
Nel primo articolo di questa serie ho raccontato un principio che considero fondamentale: il valore non nasce dal dato in sé, ma dalla capacità di trasformarlo in informazione utile per prendere decisioni. Quando però si prova a trasformare quell’idea in un prodotto reale, emerge rapidamente un secondo problema.
Non basta che il software funzioni. Deve continuare a funzionare mentre cresce.
Ed è qui che l’architettura smette di essere una discussione teorica e diventa una sequenza di decisioni molto concrete.
Nel progetto che sto sviluppando, il passaggio più interessante è stato proprio questo: partire da un’applicazione capace di elaborare dati e arrivare progressivamente a un prodotto desktop locale, con componenti distinti, lifecycle controllato, persistenza affidabile e packaging riproducibile.
Prima il dominio, poi la tecnologia
Una delle scelte che ho cercato di evitare fin dall’inizio è stata quella di progettare il sistema partendo dai framework.
Prima di chiedermi quale tecnologia utilizzare, ho cercato di individuare le responsabilità principali:
- acquisizione e parsing dei dati;
- validazione e normalizzazione;
- persistenza;
- calcolo delle statistiche;
- interpretazione dei comportamenti;
- esposizione tramite API;
- presentazione all’utente;
- gestione del ciclo di vita dell’applicazione desktop.
Solo dopo aver definito questi confini è diventato naturale assegnare una responsabilità precisa ai diversi componenti.
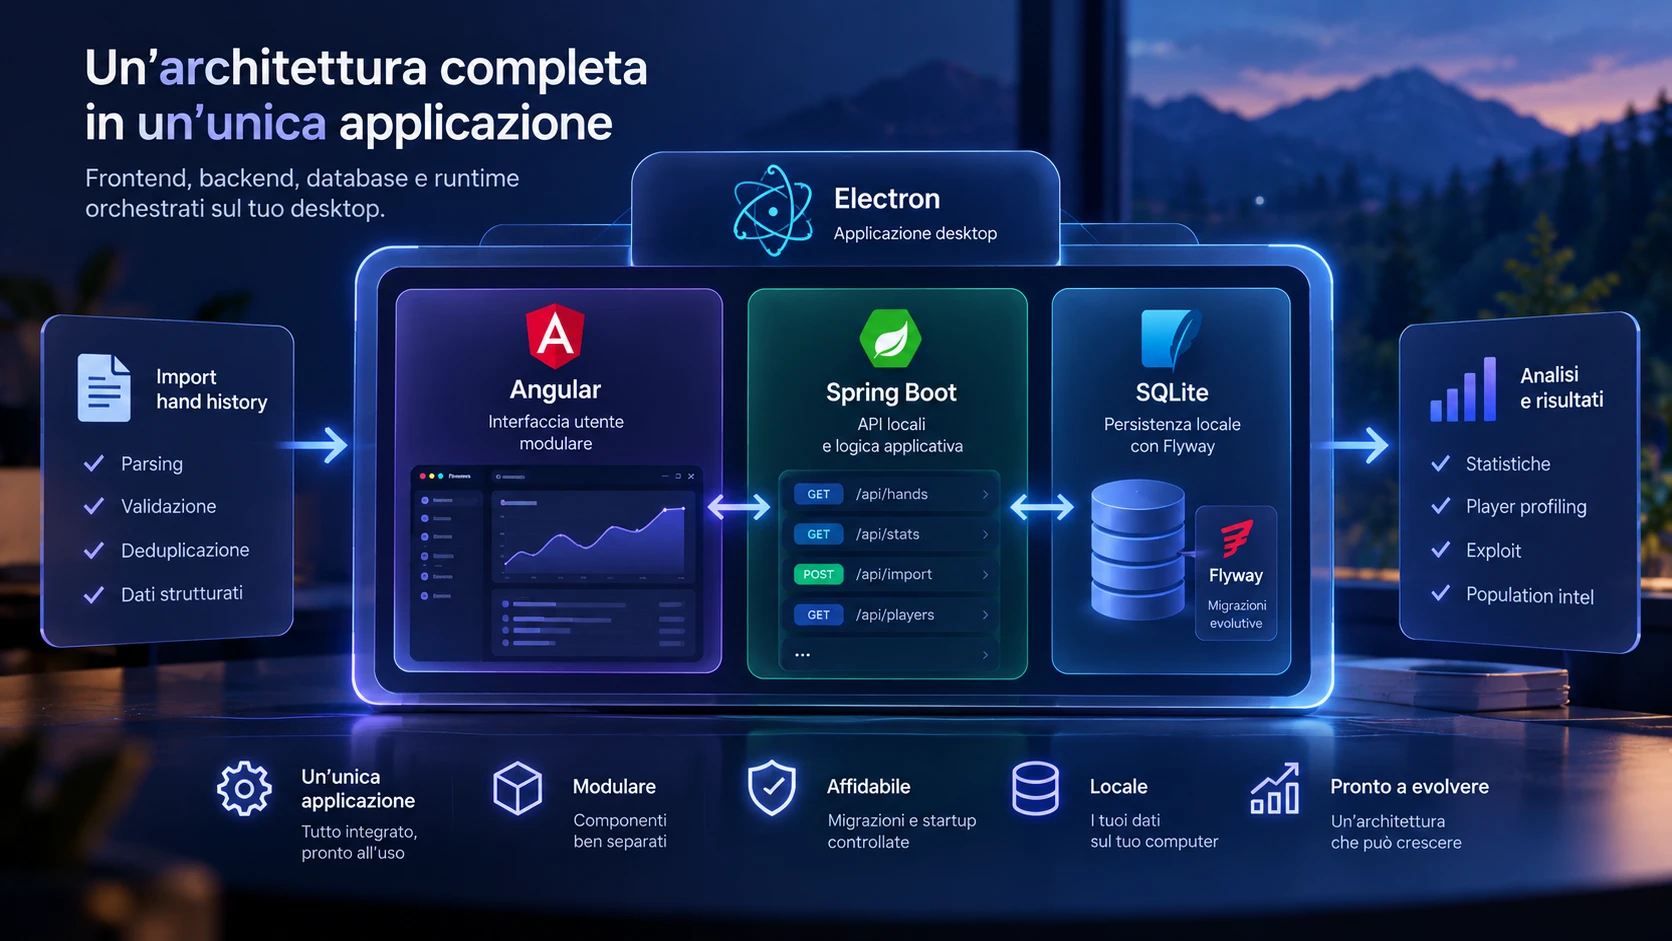
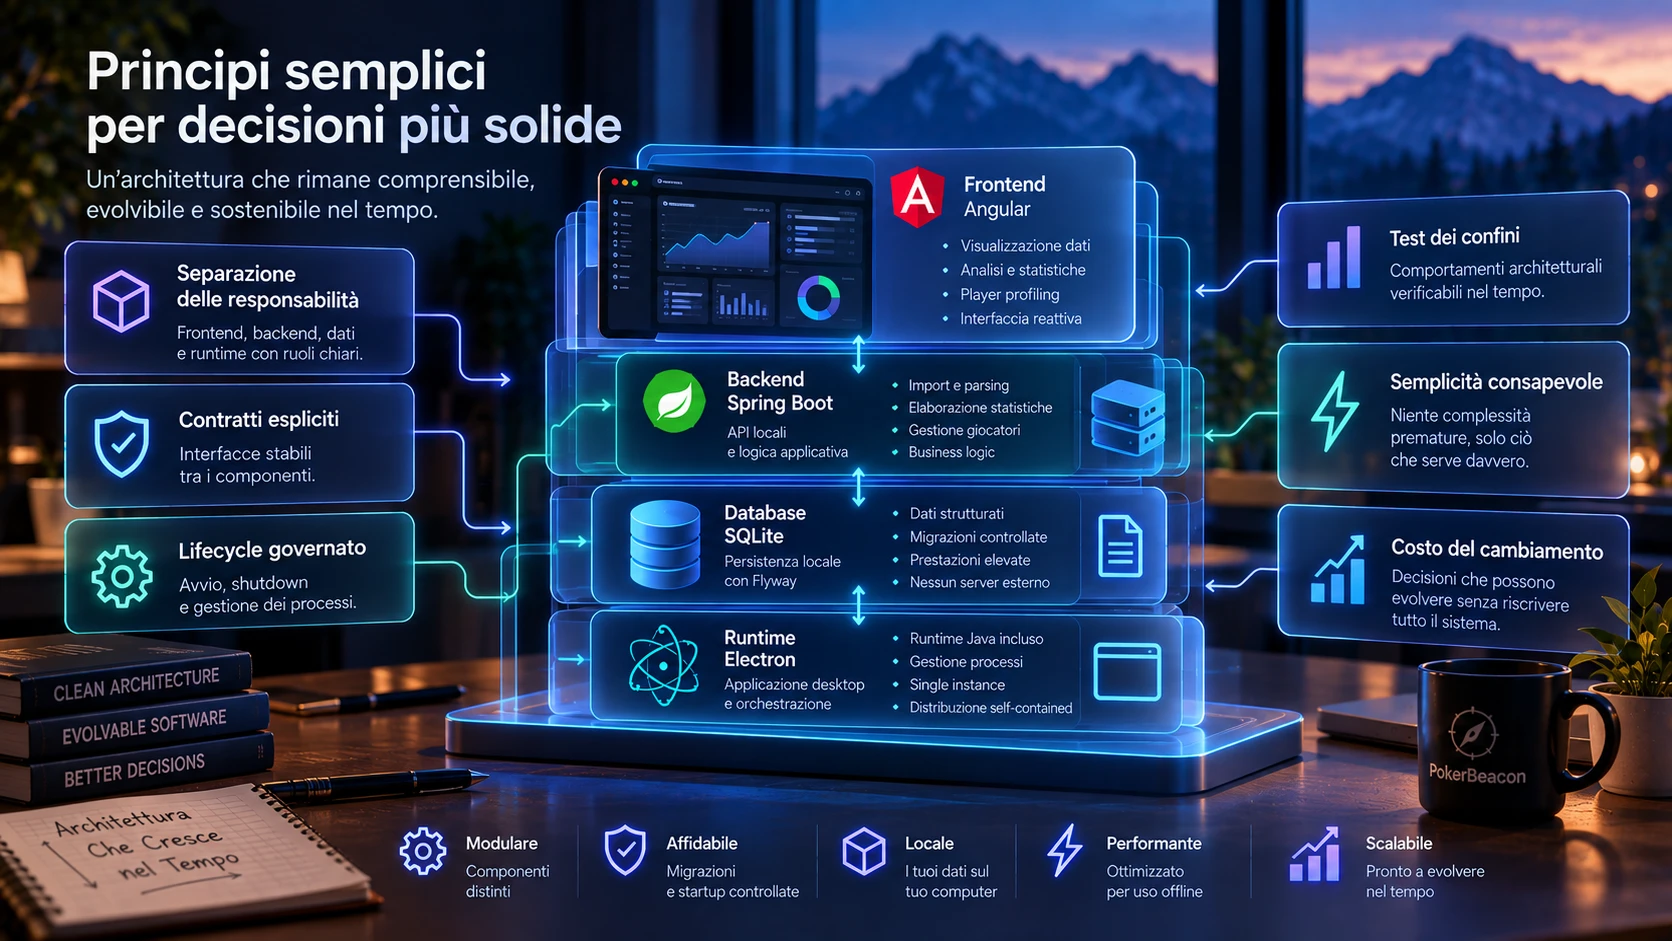
L’architettura risultante è volutamente semplice:
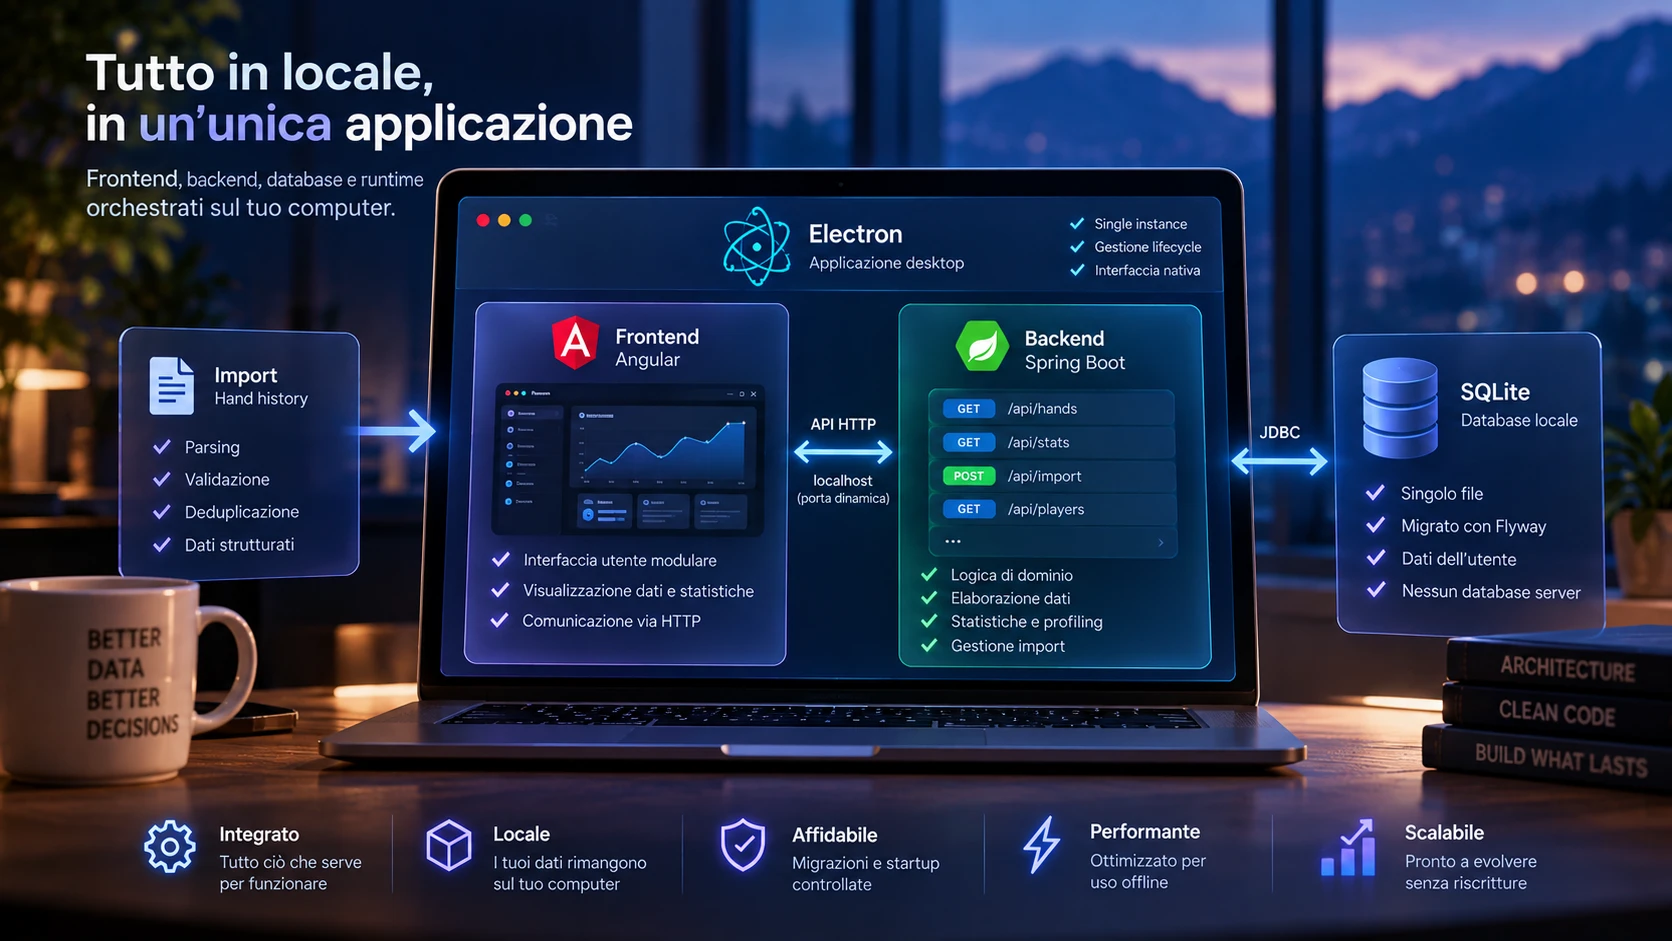
Angular → API HTTP locale → Spring Boot → SQLite
con Electron che agisce come runtime desktop e orchestratore del sistema.
Non è un’architettura distribuita nel senso tradizionale del termine, ma mantiene una separazione molto netta tra presentazione, logica applicativa e persistenza.
Perché mantenere un backend vero in un’app desktop
Una delle prime decisioni architetturali è stata quella di non portare tutta la logica dentro Electron o direttamente nel frontend.
Il motore applicativo rimane un backend Java basato su Spring Boot.
Questo significa che, anche se il prodotto viene distribuito come applicazione desktop, internamente continua ad avere confini molto chiari.
Questa scelta porta alcuni vantaggi importanti.
Il frontend non conosce il database.
Il database non conosce la UI.
Il motore statistico non dipende da Electron.
E la shell desktop non contiene la logica di dominio.
In altre parole, il fatto che il prodotto sia desktop è una caratteristica di distribuzione, non una contaminazione dell’intera architettura.
Dal modello logico al runtime reale
Definire correttamente i confini logici è però solo una parte del problema.
Quando il software deve essere distribuito su una macchina reale, diventa necessario capire anche dove vivono concretamente i diversi componenti e chi ne governa il funzionamento.
Nel pacchetto installato convivono infatti più elementi:
- il processo principale Electron;
- il frontend Angular;
- il backend Spring Boot;
- un runtime Java dedicato;
- le risorse necessarie all’applicazione.
A questi si affianca uno spazio distinto, persistente, destinato ai dati dell’utente:
- database SQLite;
- log;
- backup;
- configurazioni.
Questa separazione è intenzionale.
L’applicazione può essere aggiornata o reinstallata senza trattare i dati dell’utente come parte del software stesso.
Software installato ≠ dati dell’utente
Questa distinzione diventa fondamentale quando si passa dall’ambiente di sviluppo alla distribuzione reale: il prodotto può evolvere, ma i dati devono restare riconoscibili, preservati e governati con criteri diversi dal codice installato.
Electron come orchestratore
Electron non deve diventare il luogo in cui trasferire la logica applicativa.
Il suo ruolo è molto più preciso: orchestrare i componenti necessari affinché l’applicazione possa funzionare come un unico prodotto desktop.
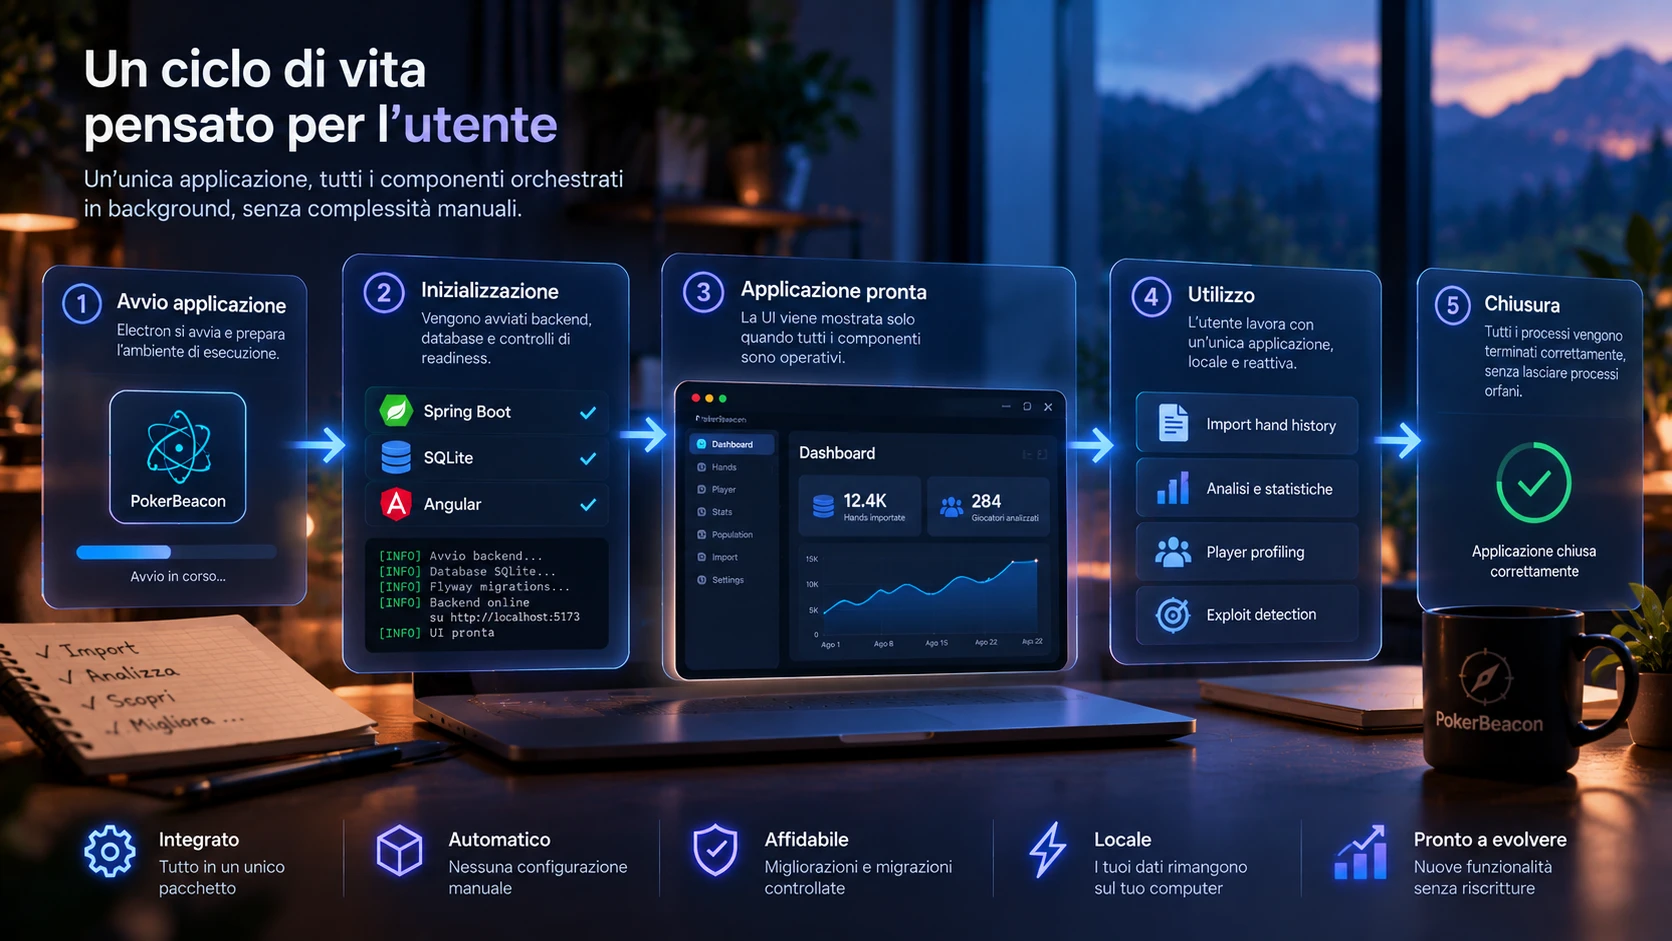
All’avvio deve quindi:
- verificare che esista una sola istanza dell’applicazione;
- individuare le risorse necessarie;
- determinare una porta locale disponibile;
- avviare il backend Java;
- verificare che il backend sia realmente pronto;
- avviare la finestra dell’applicazione;
- gestire correttamente la chiusura dei processi.
Questo rende Electron una sorta di supervisore del runtime locale.
La distinzione è importante: Electron conosce come avviare e arrestare il sistema, ma non deve conoscere le regole del dominio.
Avvio del backend e readiness
Avviare un processo non significa che quel processo sia già pronto a lavorare.
È una differenza apparentemente banale, ma molto importante quando un’applicazione desktop dipende da un backend locale.
Il processo Java può essere stato creato correttamente mentre Spring Boot sta ancora inizializzando il contesto applicativo, verificando il database o applicando le migrazioni.
Aprire il frontend troppo presto significa quindi rischiare richieste verso un servizio che esiste come processo ma non è ancora disponibile come applicazione.
La soluzione è introdurre una vera verifica di readiness.
Dopo aver avviato il backend, Electron interroga periodicamente un endpoint locale dedicato e mostra la UI soltanto quando riceve una risposta valida.
“Il processo Java è partito” e “il backend è pronto a ricevere richieste” non sono la stessa cosa.
Questa piccola distinzione rende l’avvio deterministico e permette di gestire in modo esplicito timeout, errori e fallimenti di inizializzazione.
Una porta dinamica, non una porta magica
Durante lo sviluppo è naturale utilizzare una porta fissa.
In un prodotto desktop installato su macchine che non controlliamo, quella porta potrebbe però essere già occupata.
Affidarsi a un numero scelto arbitrariamente significa introdurre una dipendenza nascosta dall’ambiente dell’utente.
Per questo il launcher può individuare una porta locale disponibile all’avvio e passarla esplicitamente al backend.
La stessa informazione viene poi utilizzata dal frontend per costruire l’indirizzo delle API locali.
Il risultato è un runtime che non dipende da una porta hardcoded e che riduce la probabilità di collisioni con altri software presenti sulla macchina.
Il principio generale è semplice: le configurazioni che dipendono dall’ambiente di esecuzione dovrebbero essere determinate o validate a runtime, invece di essere trattate come costanti universali.
Persistenza locale: SQLite e Flyway
Per un’applicazione desktop locale, SQLite rappresenta una scelta particolarmente interessante.
Non richiede un database server separato, mantiene i dati in un singolo file e consente di distribuire il prodotto senza chiedere all’utente di installare o configurare infrastruttura aggiuntiva.
La semplicità operativa, però, non elimina la necessità di governare l’evoluzione dello schema.
Quando il software cambia, anche il modello dati può cambiare.
Per questo ho mantenuto Flyway anche nel runtime desktop.
Le migrazioni diventano parte del lifecycle dell’applicazione: all’avvio il backend verifica la versione dello schema e applica in modo controllato le evoluzioni necessarie.
In questo modo il database locale non è un dettaglio lasciato alla singola installazione, ma una componente versionata del prodotto.
Software installato e dati dell’utente sono due cose diverse
Un altro passaggio importante è stato separare fisicamente ciò che appartiene all’applicazione da ciò che appartiene all’utente.
Il software installato contiene eseguibili, runtime e risorse necessarie al funzionamento.
Database, log, backup e configurazioni devono invece vivere in uno spazio persistente dedicato all’utente.
Questa separazione permette di aggiornare o reinstallare l’applicazione senza confondere il lifecycle del software con quello dei dati.
Rende inoltre più chiari aspetti come backup, troubleshooting e future strategie di migrazione.
Il principio è semplice:
Il software può essere sostituito. I dati dell’utente devono sopravvivere.
API locali, ma API vere
Il fatto che frontend e backend vengano eseguiti sulla stessa macchina non è un buon motivo per indebolire il contratto tra i due.
Le API rimangono quindi API HTTP vere, con endpoint e responsabilità esplicite.
Questo mantiene il frontend indipendente dall’implementazione interna del backend e impedisce che Electron diventi un canale alternativo attraverso cui far transitare logica di dominio.
La comunicazione rimane semplice:
Angular → HTTP → Spring Boot
anche se tutto avviene attraverso l’interfaccia locale della macchina.
Questo confine ha anche un altro vantaggio: rende i componenti più facilmente testabili e lascia aperta la possibilità di cambiare in futuro il modello di distribuzione senza riscrivere il dominio.
Single instance e lifecycle dell’applicazione
Un prodotto desktop deve gestire anche situazioni che durante lo sviluppo tendiamo facilmente a ignorare.
Cosa succede se l’utente avvia l’applicazione due volte?
Se ogni istanza avviasse il proprio backend, potremmo avere processi duplicati, porte differenti e più componenti che tentano di accedere allo stesso database.
Per questo il processo principale deve acquisire un single-instance lock.
Se un’istanza è già attiva, la seconda non costruisce un nuovo runtime: riporta invece in primo piano l’applicazione esistente.
La stessa attenzione vale per la chiusura.
Terminare la finestra non significa semplicemente chiudere Electron: bisogna assicurarsi che anche il processo backend venga arrestato correttamente e che non rimangano processi orfani.
Il lifecycle del prodotto diventa quindi una responsabilità esplicita:
avvio → readiness → utilizzo → shutdown.
Sono proprio questi dettagli, quasi invisibili quando tutto funziona, a distinguere progressivamente un prototipo da un prodotto distribuibile.
Packaging: quando il progetto diventa un prodotto
Finché un’applicazione viene eseguita dall’ambiente di sviluppo, molte complessità rimangono nascoste.
Il vero cambio di prospettiva arriva quando il software deve essere installato su una macchina sulla quale non possiamo dare nulla per scontato.
Il prodotto deve portare con sé tutto ciò che serve per funzionare.
Nel mio caso significa distribuire insieme:
- applicazione Electron;
- frontend Angular;
- backend Spring Boot;
- runtime Java dedicato;
- risorse necessarie all’avvio.
L’utente non dovrebbe conoscere questa composizione.
Dal suo punto di vista esiste una sola applicazione: la installa, la avvia e la utilizza.
Il packaging diventa quindi parte dell’architettura, non semplicemente l’ultimo comando della pipeline di build.
Se il prodotto richiede configurazioni manuali, dipendenze esterne non dichiarate o conoscenze tecniche da parte dell’utente, una parte della complessità che pensavamo di aver risolto è stata semplicemente spostata fuori dal codice.
Modularità senza sovra-ingegnerizzazione
Man mano che il progetto cresce, emerge inevitabilmente una domanda: quanto dobbiamo modularizzare?
È facile cadere in due estremi: da una parte un’applicazione monolitica nella quale ogni componente conosce tutto; dall’altra una struttura estremamente frammentata, costruita in previsione di esigenze che potrebbero non arrivare mai.
Ho preferito un approccio progressivo: separare chiaramente le responsabilità che esistono oggi, mantenendo confini che consentano di estrarle o sostituirle domani se necessario.
Non serve introdurre un nuovo livello architetturale soltanto perché potrebbe essere utile in futuro. Serve evitare che le decisioni di oggi rendano inutilmente costose quelle di domani.
Non introdurre complessità architetturale per dimostrare sofisticazione tecnica. Introdurla quando risolve un problema reale.
Modularità non significa necessariamente moltiplicare processi, servizi o repository: significa soprattutto governare dipendenze e responsabilità.
Testare anche le decisioni architetturali
I test non devono proteggere soltanto algoritmi e funzionalità.
Alcune delle proprietà più importanti del prodotto riguardano proprio i confini architetturali.
Ad esempio:
- il frontend deve comunicare con il backend attraverso il contratto previsto;
- il database deve essere inizializzato e migrato correttamente;
- l’applicazione deve poter scegliere una porta disponibile;
- la UI non deve essere mostrata prima della readiness del backend;
- una seconda istanza non deve creare un secondo runtime;
- la chiusura dell’applicazione non deve lasciare processi orfani.
Questi comportamenti raccontano qualcosa di importante.
L’architettura non è soltanto ciò che disegniamo in un diagramma.
È un insieme di proprietà che il sistema deve continuare a rispettare mentre cambia.
Per questo, quando possibile, anche le decisioni architetturali dovrebbero diventare verificabili.
Il vero obiettivo: rendere economico il cambiamento
Alla fine, il punto non è costruire l’architettura più sofisticata possibile.
È costruire un sistema che possa cambiare senza costringerci ogni volta a rimettere in discussione tutto ciò che abbiamo già realizzato.
Un prototipo ottimizza soprattutto la velocità con cui possiamo verificare un’idea.
Un prodotto deve aggiungere una seconda dimensione: la capacità di continuare a evolvere.
È qui che molte decisioni apparentemente tecniche assumono un significato più ampio.
Separare il dominio dal runtime.
Separare il software dai dati.
Rendere espliciti i contratti.
Governare il lifecycle.
Automatizzare le migrazioni.
Testare i confini.
Evitare complessità premature.
Sono scelte diverse, ma rispondono alla stessa domanda:
quanto costerà cambiare questa decisione quando il contesto sarà diverso?
Organizzare il software oggi in modo da mantenere ragionevole il costo delle decisioni di domani.
È probabilmente questa la lezione più interessante che sto ricavando dal progetto.
L’architettura non serve a prevedere perfettamente il futuro.
Serve a evitare che ogni cambiamento futuro diventi una riscrittura.
Ed è un principio che vale ben oltre il software: nei progetti, nei team e nelle organizzazioni, una buona struttura non elimina il cambiamento.
Lo rende governabile.