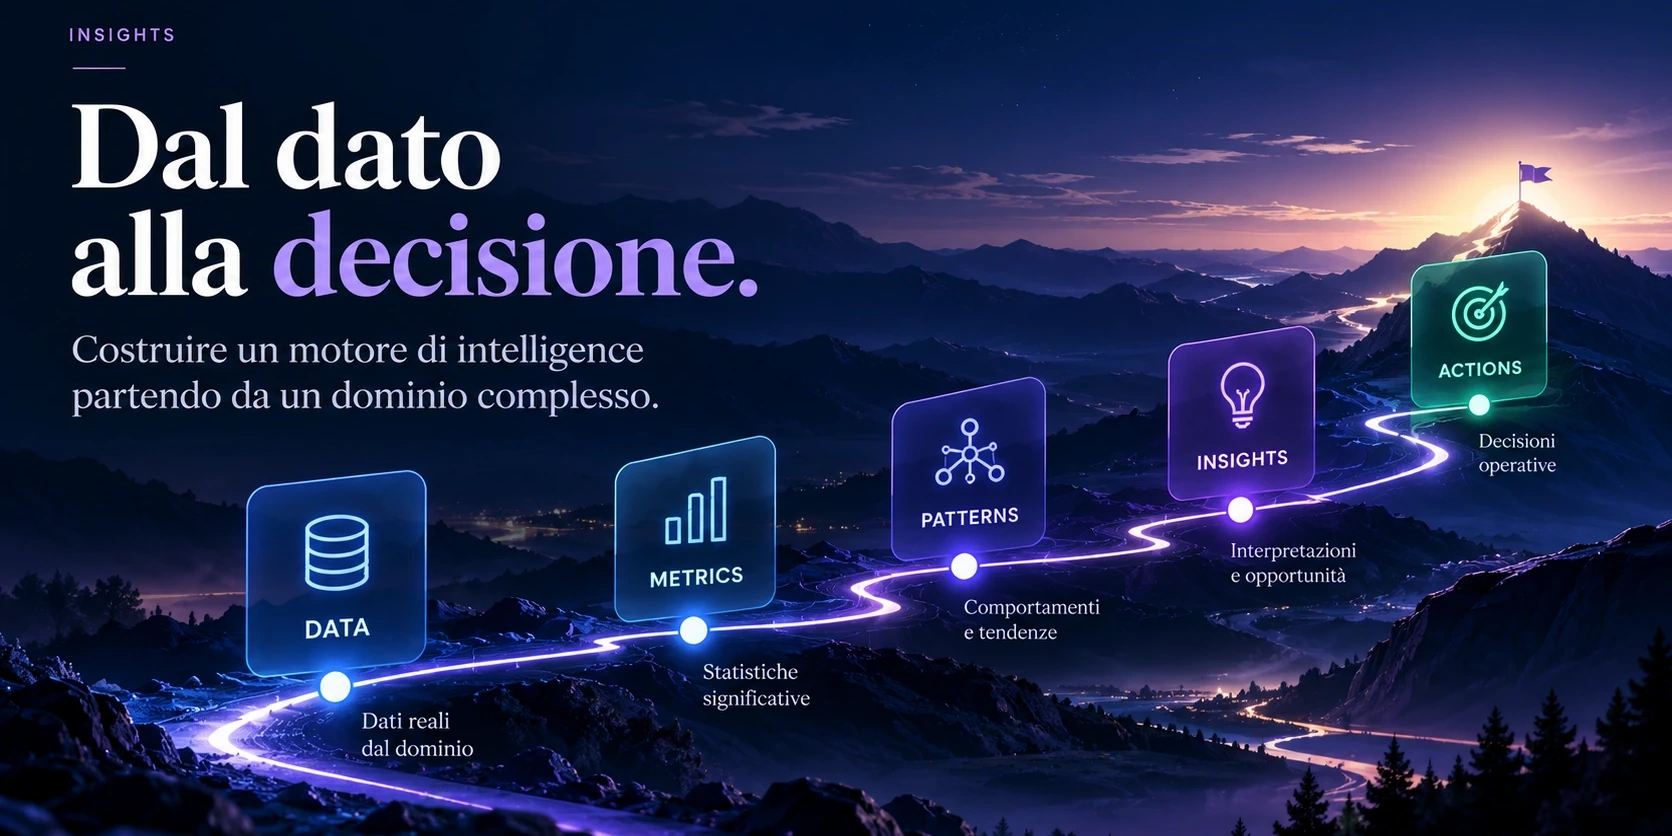
Quando ho iniziato a lavorare su questo progetto, la domanda sembrava semplice:
come trasformare migliaia di eventi grezzi in informazioni realmente utili per prendere decisioni migliori?
Il progetto nasce come laboratorio personale di engineering applicato a un dominio che conosco bene: il poker online.
Non mi interessava costruire semplicemente un altro tracker capace di mostrare statistiche. Volevo capire cosa succede quando proviamo a percorrere tutta la distanza che separa un dato grezzo da una decisione.
Un laboratorio personale di engineering
Negli ultimi anni il mio lavoro si è progressivamente spostato dallo sviluppo software verso architettura, Project e Delivery Management, coordinamento di team e organizzazioni più complesse.
Costruire questo prodotto mi ha dato l’occasione di tornare direttamente sul ciclo completo:
dominio → dati → architettura → backend → frontend → analytics → intelligence → UX.
È un esercizio tecnico, ma soprattutto un modo per ragionare su problemi che ritroviamo in moltissimi sistemi informativi.
Perché raccogliere dati è relativamente semplice.
Trasformarli in conoscenza affidabile lo è molto meno.
Il problema iniziale sembrava semplice
Una hand history contiene una grande quantità di eventi:
- giocatori;
- posizioni;
- stack;
- azioni;
- puntate;
- carte;
- street;
- risultati;
- contesto del torneo.
Presi singolarmente sono fatti.
Il primo problema è renderli strutturati, coerenti e interrogabili.
Il sistema deve riconoscere gli eventi, normalizzarli e conservarli mantenendo il significato del dominio.
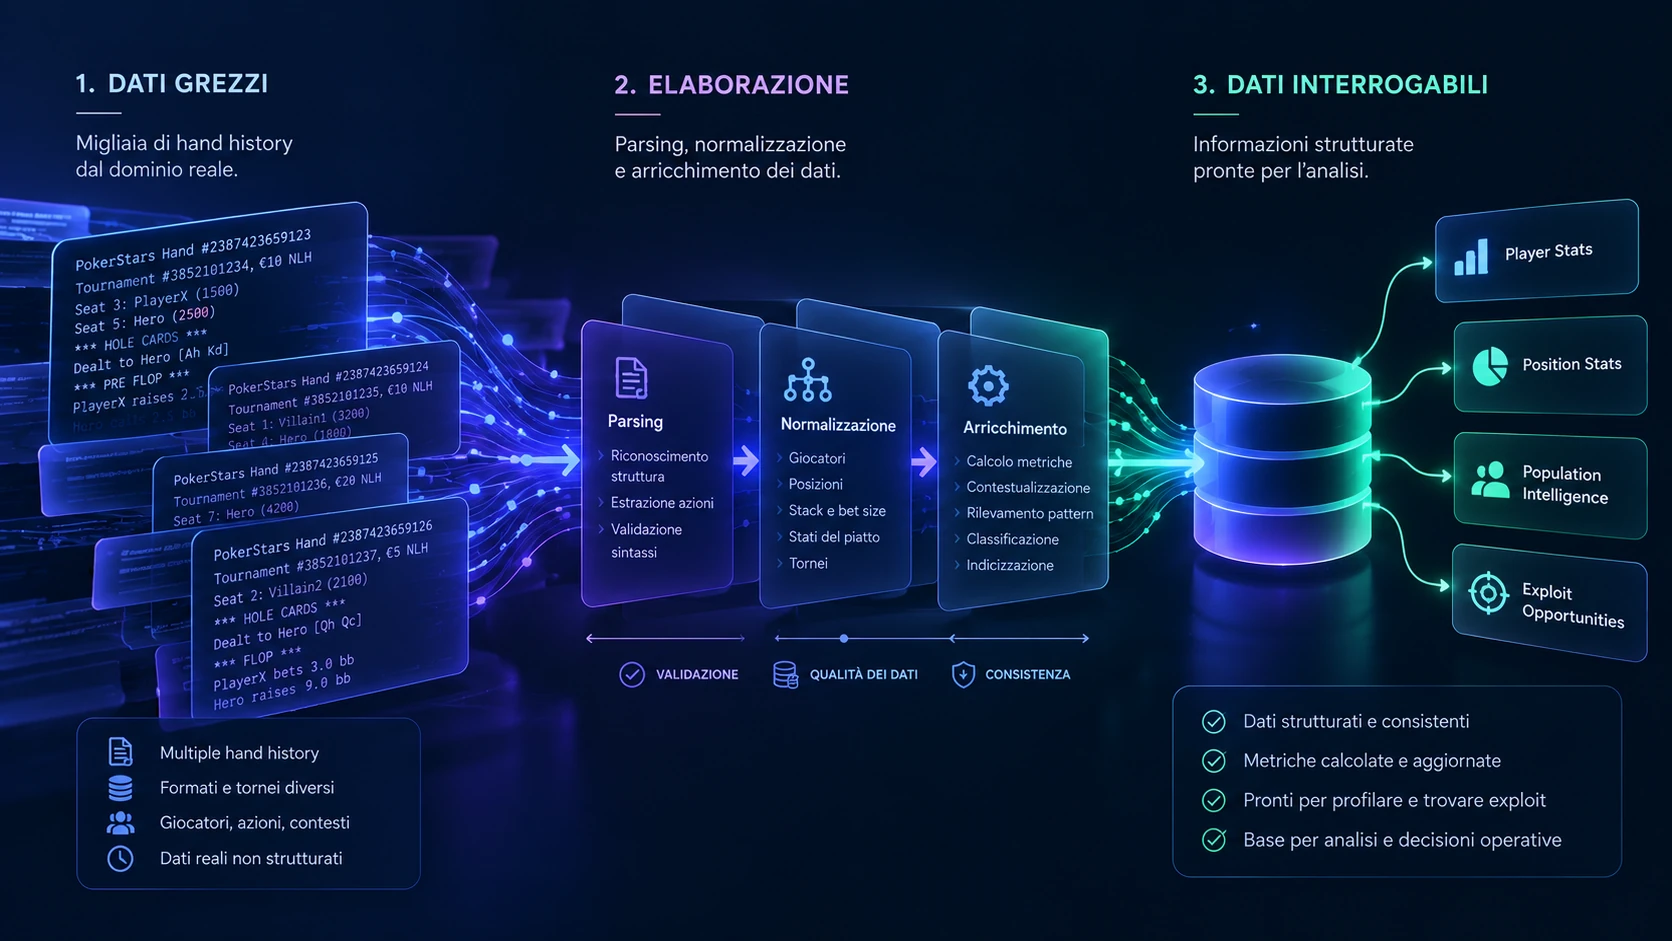
Ma arrivare a una base dati corretta è soltanto l’inizio.
Dal dato alla conoscenza
La pipeline concettuale che ho iniziato a utilizzare è questa:
DATA → METRICS → PATTERNS → INSIGHTS → ACTIONS
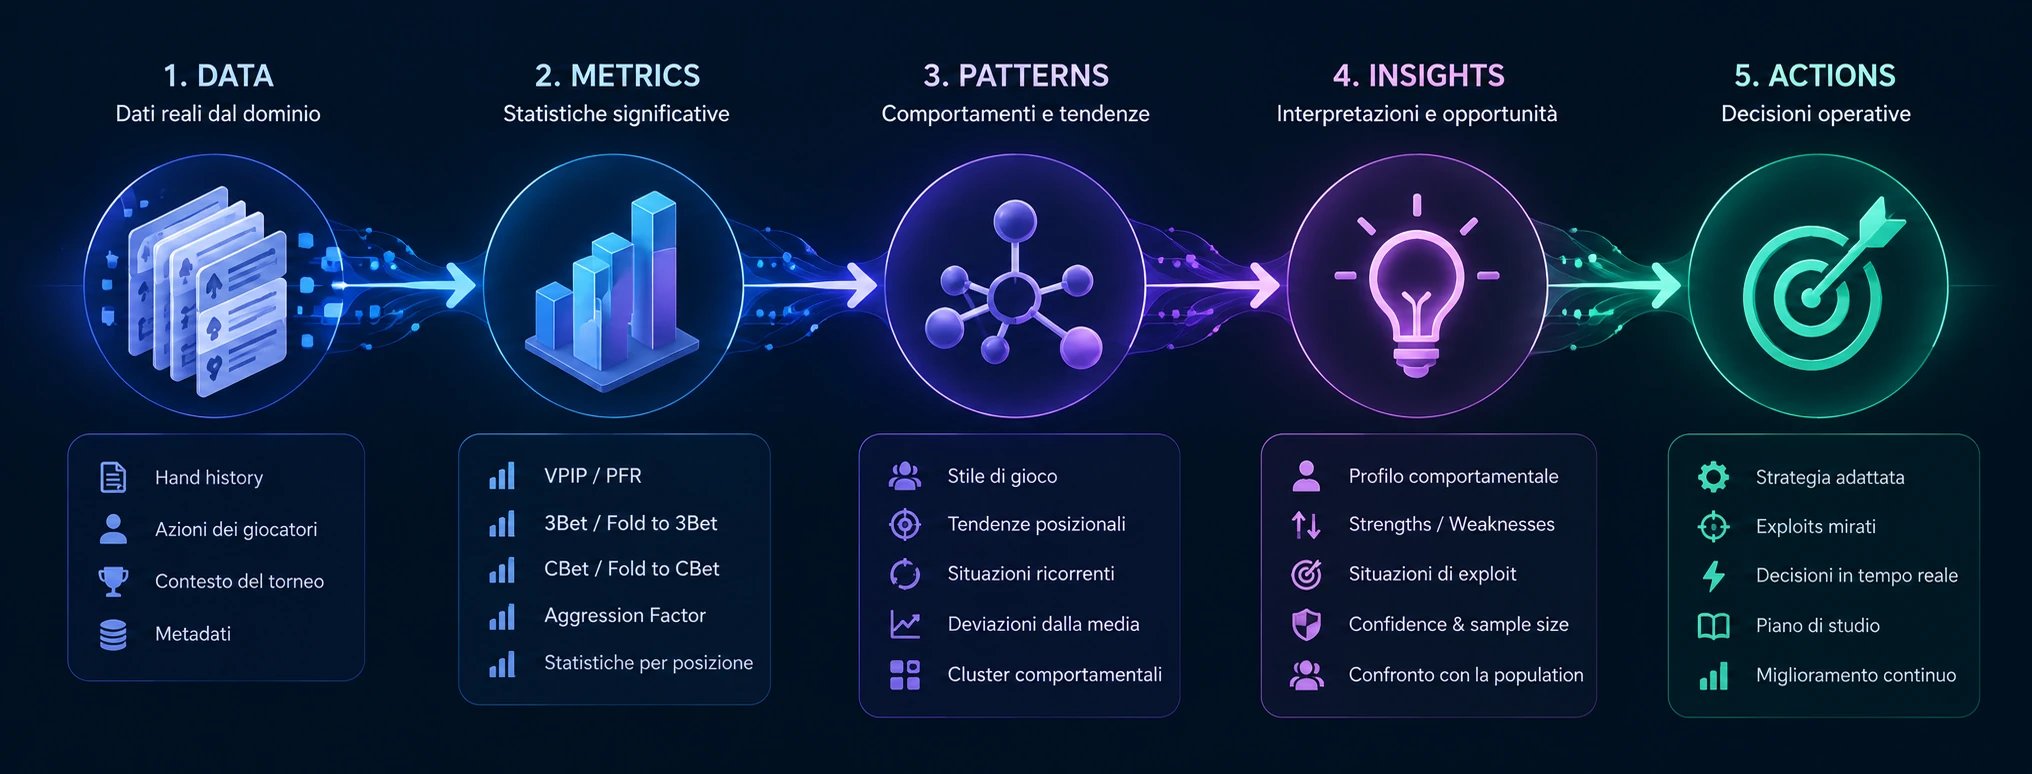
A ogni passaggio aumenta il valore dell’informazione, ma aumenta anche il rischio di introdurre interpretazioni sbagliate.
Un evento può essere corretto.
Una statistica calcolata su quell’evento può essere corretta.
Eppure la conclusione derivata dalla statistica può essere completamente sbagliata.
È qui che il problema smette di essere soltanto software engineering.
Una percentuale non è ancora informazione
Supponiamo che un giocatore abbia una determinata percentuale di fold in una certa situazione.
Il numero, da solo, dice molto meno di quanto sembri.
Quante opportunità abbiamo osservato?
Su quale campione?
In quali posizioni?
In quale contesto?
Quanto è stabile quella misura?
Visualizzare un numero è facile. Decidere quanto possiamo fidarci di quel numero è molto più difficile.
Da qui nasce la necessità di trattare insieme almeno tre elementi:
metrica, sample size e confidence.
Non basta sapere che un comportamento si è verificato nel 70% dei casi.
Serve sapere se quel 70% deriva da 3 opportunità o da 300.
Questo cambia radicalmente il significato dell’informazione.
Dalle metriche al profiling
Una volta costruite metriche sufficientemente affidabili, possiamo iniziare a cercare pattern.
Aggressività.
Propensione allo steal.
Difesa dei blind.
Pressione postflop.
Passività.
Disciplina.
Tendenze per posizione.
Questi segnali, osservati insieme, permettono di costruire un profilo comportamentale più leggibile del semplice elenco di statistiche.
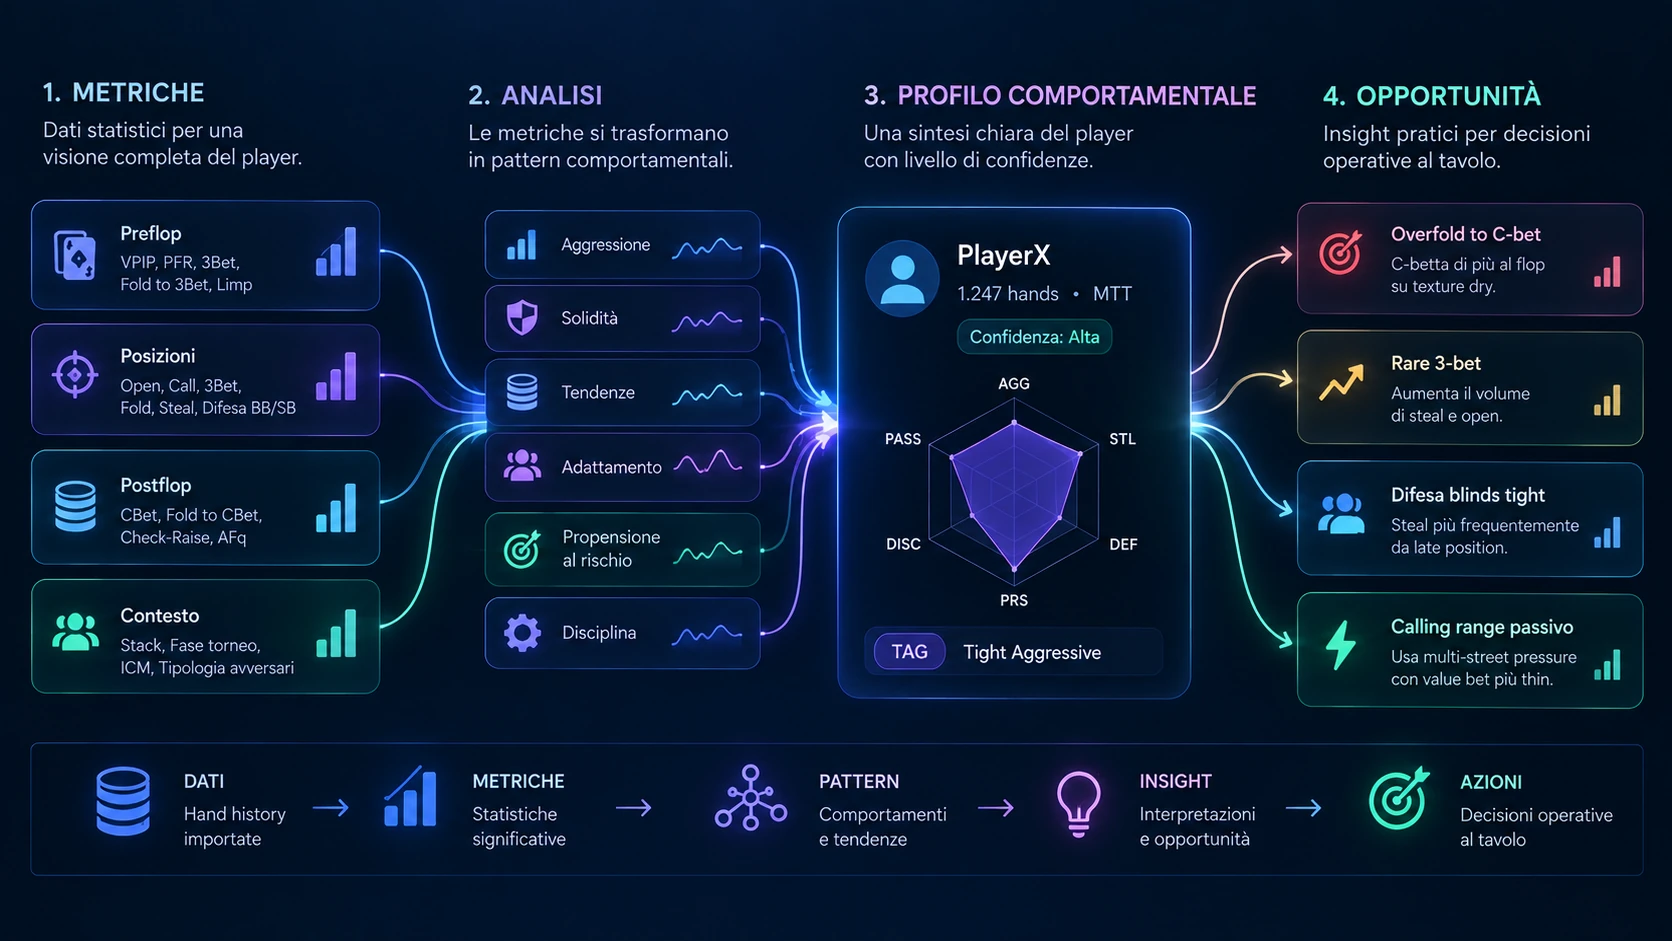
Il punto non è assegnare un’etichetta definitiva a una persona.
È sintetizzare ciò che i dati osservati suggeriscono, indicando anche quanto possiamo essere confidenti in quella lettura.
Il passaggio più interessante: dagli insight alle azioni
La parte che trovo più interessante arriva quando il sistema prova a trasformare i pattern in opportunità operative.
Per esempio:
- un’eccessiva frequenza di fold può suggerire maggiore pressione;
- una frequenza di 3-bet molto bassa può cambiare il modo in cui interpretiamo determinate azioni;
- una difesa dei blind particolarmente tight può creare opportunità di steal;
- un calling range passivo può modificare il modo in cui costruiamo la pressione sulle street successive.
Ma una raccomandazione senza spiegazione è poco utile.
Per questo sto lavorando sull’idea di una catena esplicita:
diagnosi → evidenze → confidence → possibile azione
Un sistema di intelligence non dovrebbe soltanto dire cosa ha trovato. Dovrebbe riuscire a spiegare perché lo ha trovato.
L’explainability non è quindi un’aggiunta estetica all’interfaccia.
È parte del modello.
Intelligence significa anche responsabilità
Quando iniziamo a costruire profili comportamentali emerge anche un’altra domanda.
Solo perché possiamo derivare qualcosa dai dati significa che dovremmo sempre farlo?
Il tema supera naturalmente il poker.
Profiling, sistemi decisionali, GDPR, AI Act e privacy-by-design stanno rendendo sempre più importante distinguere tra capacità tecnica e utilizzo responsabile.
Un buon sistema di intelligence deve quindi interrogarsi non soltanto sulla precisione dei propri modelli, ma anche sulla trasparenza delle inferenze e sul modo in cui vengono utilizzate.
Dal singolo individuo alla popolazione
Analizzare un singolo profilo è utile.
Ma molti comportamenti diventano realmente interessanti quando possiamo confrontarli con una popolazione.
Una statistica isolata ci dice cosa fa un giocatore.
Una distribuzione ci aiuta a capire quanto quel comportamento sia normale o anomalo rispetto al contesto osservato.
Da qui nasce un secondo livello del progetto: la Population Intelligence.
Non soltanto:
“quanto spesso accade?”
ma:
“quanto questo comportamento si discosta da ciò che osserviamo normalmente?”
È un passaggio importante perché trasforma il database da archivio storico a strumento di confronto.
E l’intelligenza artificiale?
L’AI è entrata nel progetto soprattutto come acceleratore del processo di engineering.
Analisi del codice.
Refactoring.
Test.
Esplorazione di alternative architetturali.
Documentazione.
Revisione.
Prototipazione.
Ma il modello che trovo più utile non è:
prompt → codice → prodotto.
È piuttosto:
Human-driven engineering. AI-accelerated execution.
Le decisioni sul dominio, sull’architettura, sui trade-off e sul significato dei dati rimangono responsabilità umane.
L’AI può comprimere enormemente il tempo necessario per esplorare, implementare e verificare quelle decisioni.
Costruire il prodotto mi sta insegnando più del prodotto stesso
Il risultato più interessante di questo progetto, almeno per me, non è il software in sé.
Sono le domande che continua a generare.
- Quando un campione diventa significativo?
- Come rappresentiamo l’incertezza?
- Quanto deve essere spiegabile una raccomandazione?
- Dove finisce una statistica e dove inizia un’interpretazione?
- Quanto dobbiamo separare i fatti persistiti dalle informazioni derivate?
- Come costruiamo un’architettura che possa evolvere senza perdere affidabilità?
Sono domande tecniche.
Ma sono anche domande di prodotto, governance e decision making.
Ed è probabilmente questo l’aspetto che trovo più interessante del tornare a costruire direttamente:
dietro ogni riga di codice ci sono decisioni.
E imparare a rendere migliori quelle decisioni è molto più interessante che limitarsi a scrivere software.