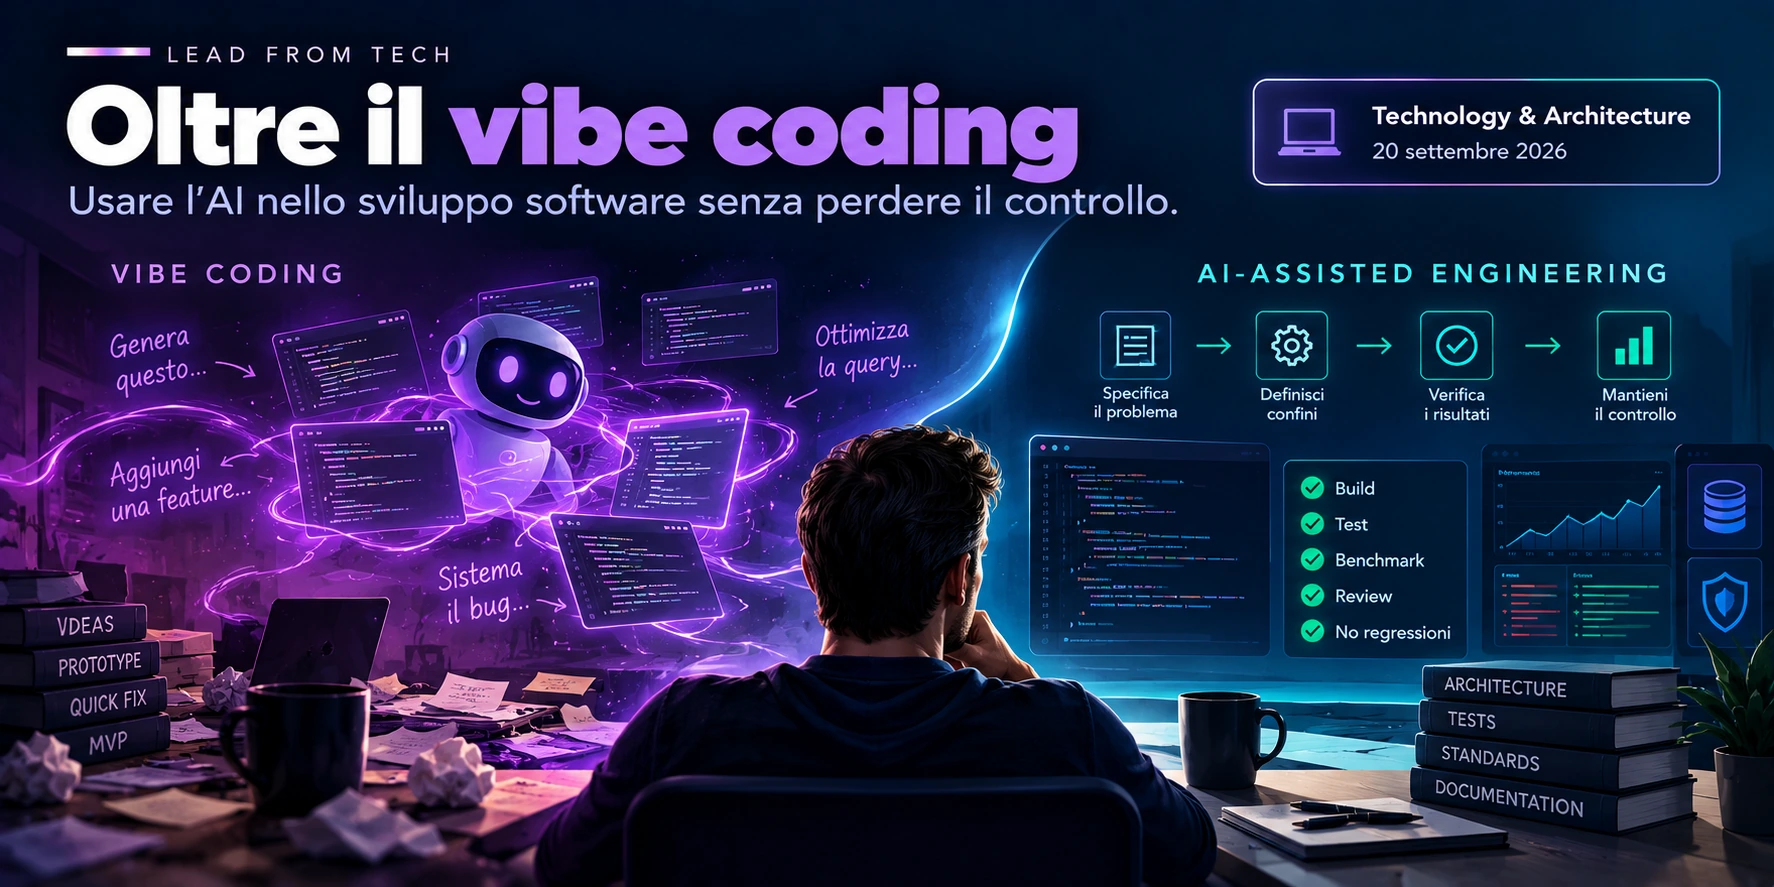
Negli ultimi mesi ho usato strumenti di AI coding in modo sempre più intenso durante lo sviluppo di un prodotto reale.
Non per costruire una demo.
Non per vedere quanto codice potessero generare.
Ma per lavorare su un sistema che, nel frattempo, diventava progressivamente più complesso: parsing, persistenza, analytics, query, API, frontend, performance, test, refactoring.
All’inizio la promessa sembra semplice:
descrivi ciò che vuoi e lascia che l’AI lo costruisca.
È il fascino del vibe coding.
Funziona sorprendentemente bene.
Almeno fino a quando il problema non è più generare codice.
Il problema diventa mantenere il controllo sul sistema che quel codice sta costruendo.
È lì che, per me, cambia tutto.
Il passaggio interessante non è:
human coding → AI coding
È:
AI-generated software → AI-assisted engineering
E la differenza sta soprattutto in una parola:
judgment.
Generare codice non è engineering
Con un coding agent posso produrre molto velocemente:
- endpoint;
- query;
- componenti;
- test;
- migrazioni;
- refactoring;
- documentazione.
Questo riduce drasticamente il costo dell’esecuzione.
Ma non riduce automaticamente il costo delle decisioni.
Qual è il problema che stiamo davvero risolvendo?
Quale parte del sistema può essere modificata?
Quali invarianti devono rimanere intatti?
Quando una soluzione è abbastanza buona?
Quale regressione sarebbe inaccettabile?
Quando conviene fermarsi?
Sono domande che esistevano già prima dell’AI.
La differenza è che oggi possiamo produrre una soluzione sbagliata molto più velocemente.
Più l’esecuzione diventa economica, più il giudizio diventa prezioso.
Il problema dei prompt troppo aperti
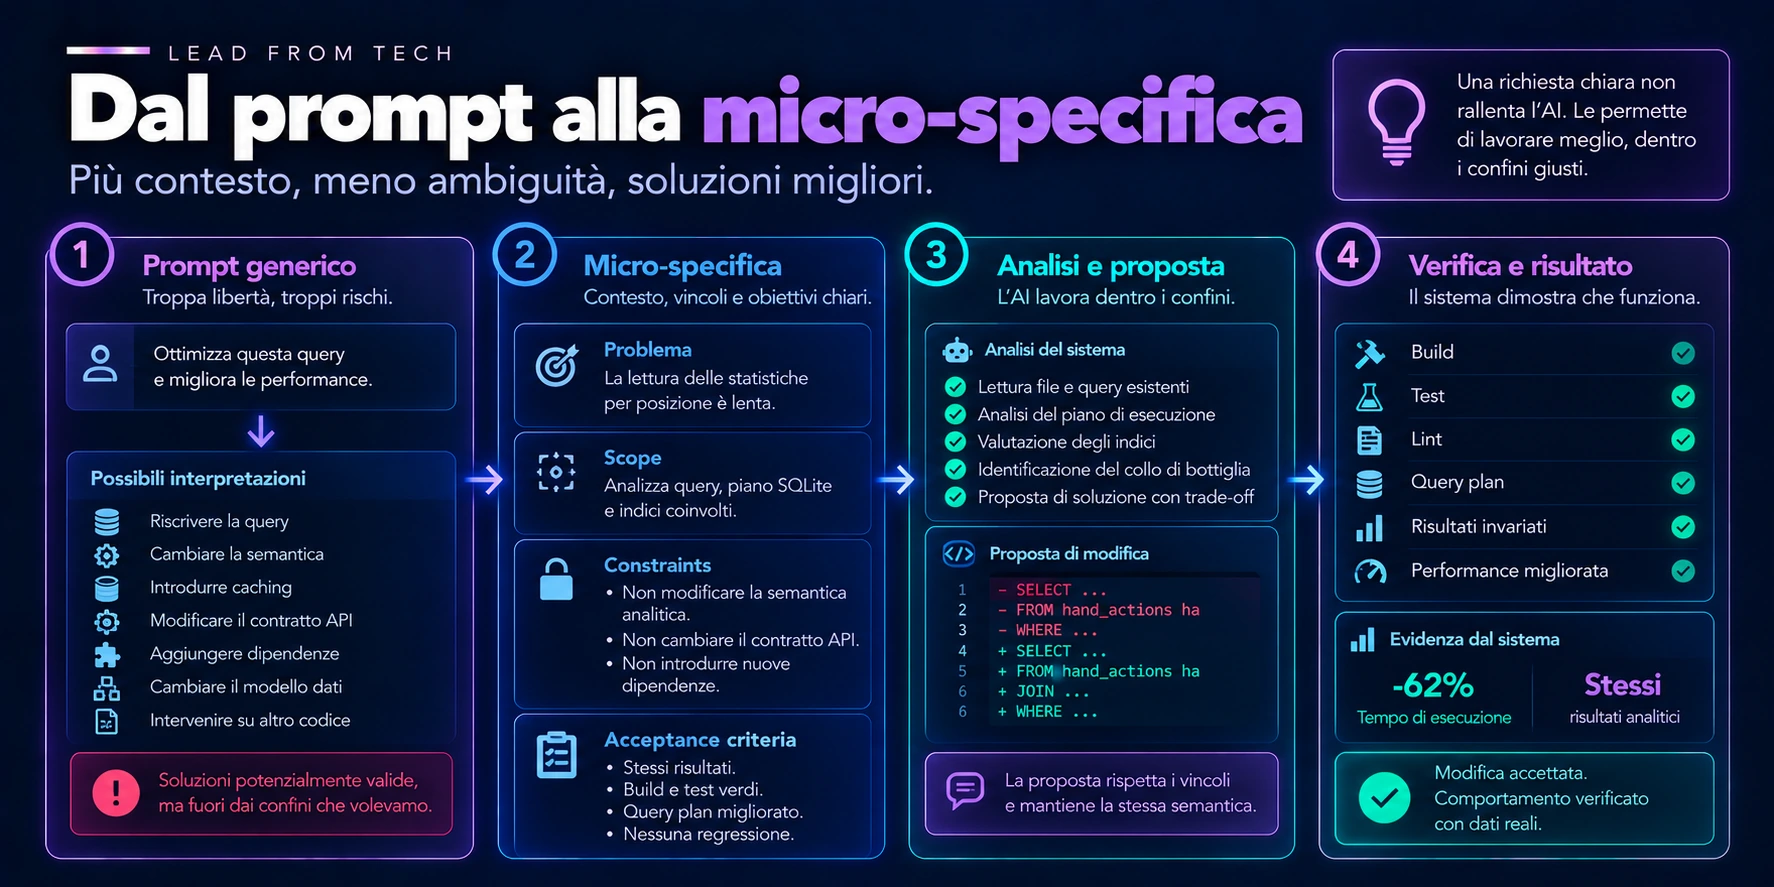
Una richiesta come:
“ottimizza questa query”
sembra perfettamente ragionevole.
Ma lascia aperte moltissime interpretazioni.
L’AI potrebbe:
- riscrivere la query;
- cambiare la semantica;
- introdurre caching;
- modificare il contratto dell’API;
- aggiungere dipendenze;
- cambiare il modello dati;
- intervenire su codice che non era parte del problema.
Potrebbe persino produrre qualcosa di tecnicamente migliore.
E comunque violare ciò che volevamo ottenere.
Il problema non è necessariamente la qualità della soluzione.
È l’assenza di confini.
Dal prompt alla micro-specifica
Ho iniziato quindi a trattare molte richieste all’AI come piccole specifiche tecniche.
Non:
“migliora le performance.”
Ma qualcosa di più vicino a:
Problema
La lettura delle statistiche per posizione è lenta.
Scope
Analizza query, piano SQLite e indici coinvolti.
Constraints
Non modificare la semantica analitica.
Non cambiare il contratto API.
Non introdurre nuove dipendenze.
Acceptance criteria
La query deve restituire gli stessi risultati.
La build deve passare.
I test esistenti devono rimanere verdi.
Il piano di esecuzione deve mostrare il miglioramento atteso.
Questa forma di richiesta cambia radicalmente il rapporto con il coding agent.
Non gli sto più chiedendo:
“trova una soluzione.”
Gli sto dicendo:
“lavora dentro questo spazio decisionale.”
Read first, change later
Una delle regole che si è rivelata più utile è stata estremamente semplice:
prima leggere, poi modificare.
Prima di chiedere una patch:
- leggere i file coinvolti;
- ricostruire il flusso;
- individuare dipendenze;
- verificare test esistenti;
- identificare invarianti;
- spiegare la causa probabile.
Solo dopo:
proporre una modifica.
Sembra un rallentamento.
In pratica spesso accelera il lavoro.
Evita patch costruite su una comprensione parziale del sistema.
E soprattutto riduce un rischio tipico dell’AI coding: modificare correttamente il file sbagliato o risolvere elegantemente il problema sbagliato.
“Done” non significa verificato
C’è poi un’altra distinzione fondamentale.
Un coding agent può dire:
“Implemented successfully.”
Ma quella frase non è un’evidenza.
È un’affermazione.
L’evidenza arriva dal sistema.
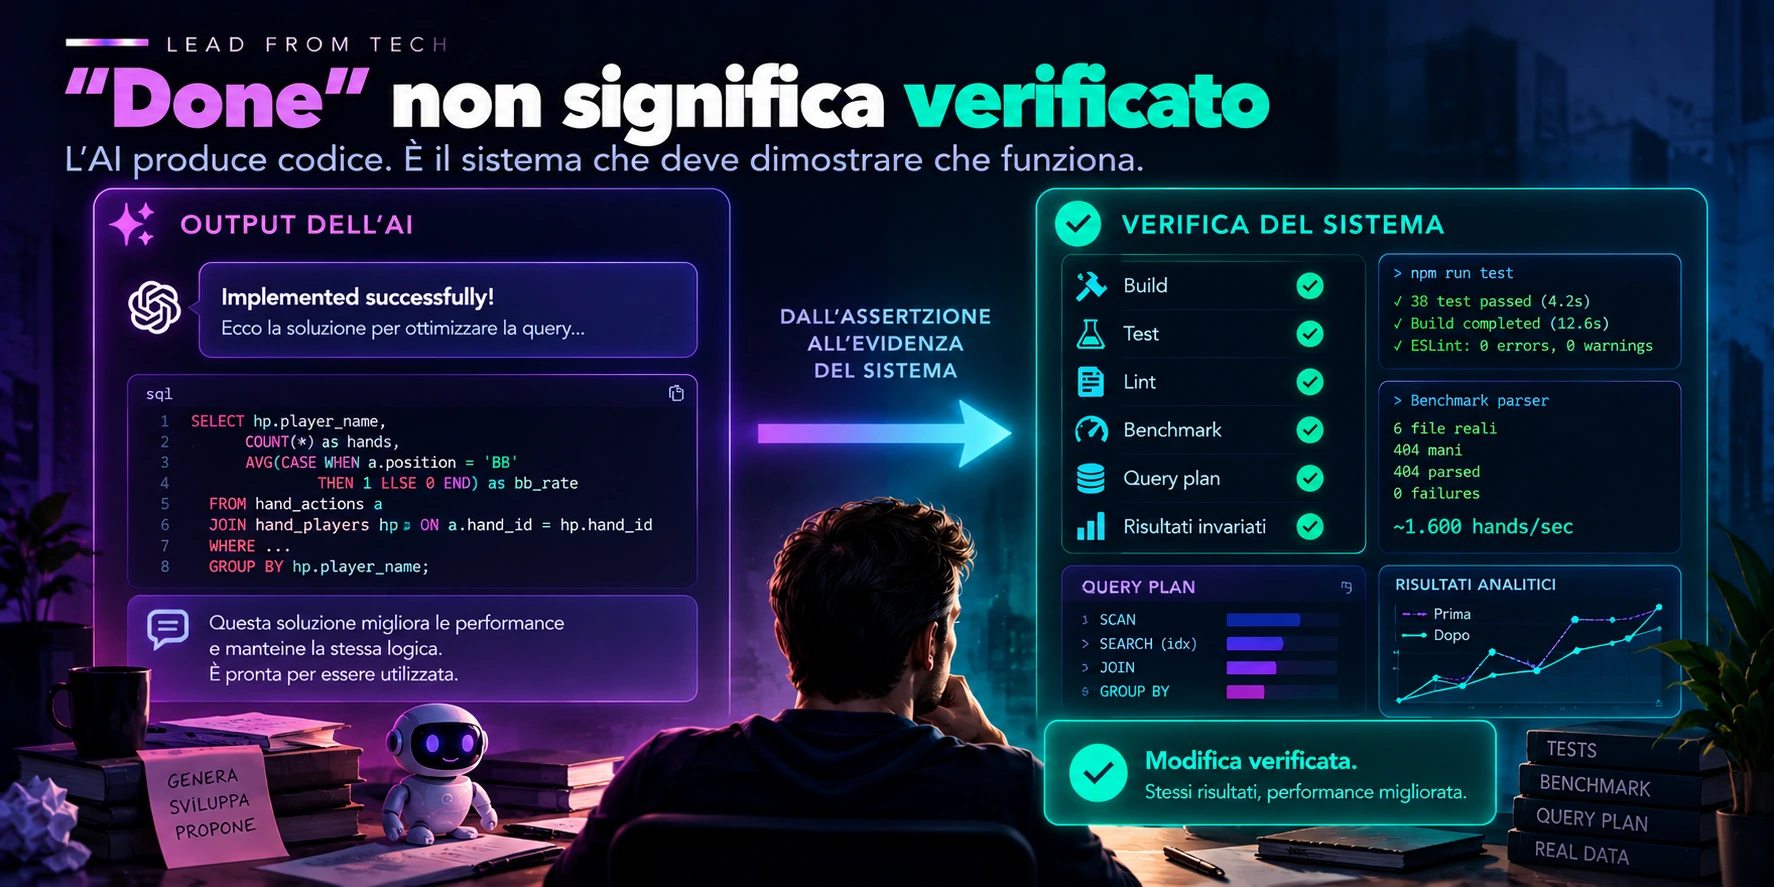
Durante lo sviluppo del parser, per esempio, la verifica non consisteva nel chiedere al modello se il parser funzionasse.
Consisteva nell’eseguirlo su dati reali.
In una fase del progetto il corpus di verifica conteneva:
6 file reali
404 mani
Il risultato:
404 parsed
0 failures
Su un file da 117 mani, il tempo osservato era nell’ordine di:
~72 ms
circa:
~1.600 hands/sec
nel relativo ambiente di test.
Quei numeri non dimostrano che il parser sia perfetto.
Dimostrano qualcosa di molto più circoscritto e utile:
in quel corpus e in quell’ambiente, il comportamento osservato rispettava quei criteri.
Questa distinzione è essenziale.
L’AI può produrre il codice.
La verifica deve produrre l’evidenza.
Build, test, benchmark, diff
Il pattern si è ripetuto continuamente.
Dopo una modifica:
build
→ tests
→ lint
→ benchmark
→ inspect diff
Non tutti i passaggi servono sempre.
Dipende dal tipo di cambiamento.
Ma il principio rimane:
la risposta del modello non è il criterio di accettazione.
Se modifico una query, guardo risultati e query plan.
Se modifico il parser, uso input reali.
Se intervengo sul frontend, verifico comportamento, build e regressioni.
Se faccio refactoring, controllo che il diff non abbia cambiato la semantica.
Più aumenta la velocità di generazione, più deve aumentare la disciplina di verifica.
Il diff come unità di controllo
Con l’AI è facile ottenere patch molto grandi.
E una patch grande può sembrare produttiva.
Ma ogni riga aggiunta amplia lo spazio che dobbiamo comprendere e verificare.
Ho iniziato quindi a preferire modifiche più piccole e intenzionali.
Un problema.
Un perimetro.
Una patch.
Una verifica.
Poi il passo successivo.
Non sempre è il modo più veloce di generare codice.
Spesso è il modo più veloce di mantenere comprensibile il sistema.
A volte la soluzione migliore è togliere
Gli strumenti generativi hanno una naturale facilità nell’aggiungere.
Nuove astrazioni.
Nuovi helper.
Nuovi componenti.
Nuovi layer.
Ma migliorare un sistema non significa necessariamente aumentare ciò che contiene.
Durante alcuni refactoring, la domanda più utile non è stata:
“cosa possiamo aggiungere?”
È stata:
“cosa possiamo eliminare senza perdere comportamento?”
Codice duplicato.
Percorsi ormai inutilizzati.
Logica diventata ridondante.
Caricamenti anticipati non necessari.
Complessità accidentale.
Anche il lazy loading del frontend, per esempio, non riguardava soltanto aggiungere una tecnica.
Riguardava decidere cosa non caricare finché non serve.
La sottrazione è engineering quanto la generazione.
L’AI come reviewer
Uno dei cambiamenti più interessanti è arrivato quando ho smesso di usare l’AI soltanto per scrivere codice.
Può essere molto utile anche come reviewer.
Ma la domanda conta.
Chiedere:
“questa implementazione va bene?”
invita facilmente alla conferma.
Molto più utile:
“cerca regressioni.”
“trova edge case che non sto coprendo.”
“quali assunzioni sto facendo?”
“dove può cambiare involontariamente la semantica?”
“cerca codice morto o duplicazioni.”
“quale parte di questa soluzione è più fragile?”
In questo modo l’AI non è soltanto un generatore.
Diventa uno strumento per creare attrito critico.
E questo, spesso, vale più di qualche centinaio di righe prodotte più velocemente.
Separare design e coding
Un altro pattern che ha funzionato bene è stato separare due momenti.
Prima il design.
Poi l’implementazione.
Per modifiche non banali:
- analizzare il problema;
- ricostruire il sistema esistente;
- proporre l’approccio;
- valutare trade-off e rischi;
- definire i criteri di accettazione;
- solo allora modificare il codice.
Questo rende più semplice fermare una direzione sbagliata prima che diventi una patch da centinaia di righe.
Con un coding agent veloce, la capacità di dire “non implementare ancora” diventa sorprendentemente importante.
Un workflow più disciplinato
Progressivamente il mio flusso di lavoro è diventato qualcosa del genere:
Problem
↓
Read existing system
↓
Define scope
↓
Define constraints
↓
Define acceptance criteria
↓
AI analyze / propose
↓
Review design
↓
Implement
↓
Build / Test / Benchmark
↓
Inspect diff
↓
Accept or iterate
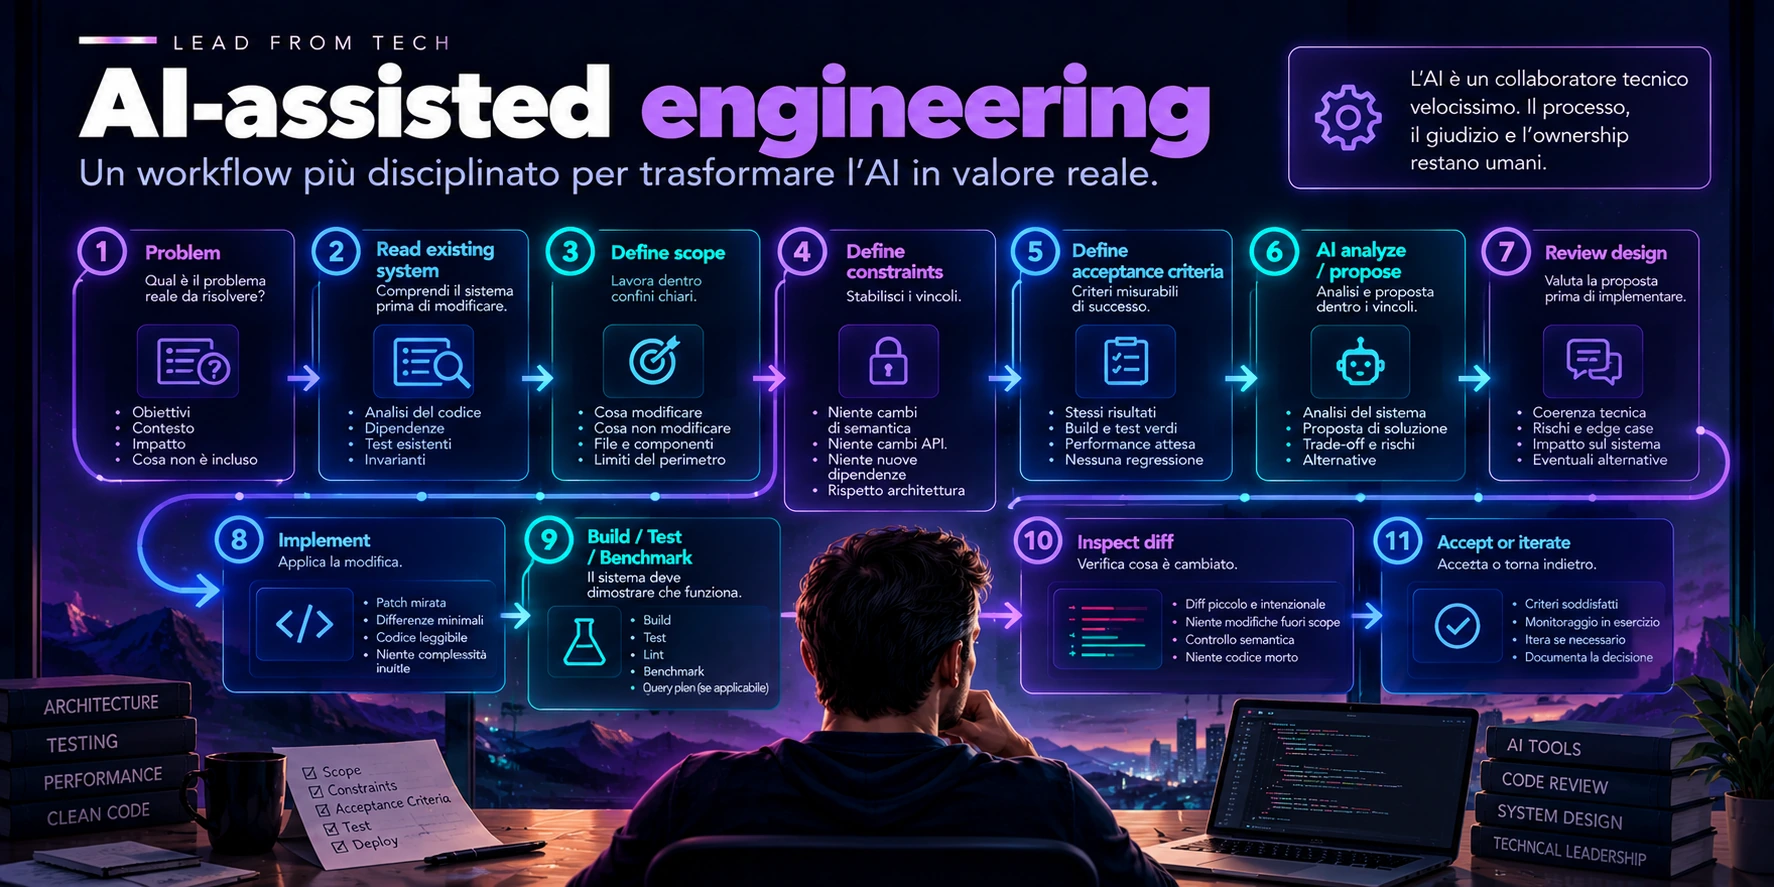
Guardandolo così, l’AI occupa una parte importante del processo.
Ma non possiede il processo.
Questa, per me, è la differenza fondamentale.
I guardrail non rallentano l’AI
Scope.
Constraints.
Test.
Architecture rules.
Small diff.
Review.
Acceptance criteria.
Potrebbero sembrare ostacoli alla velocità.
In realtà permettono di utilizzare quella velocità senza trasformarla in entropia.
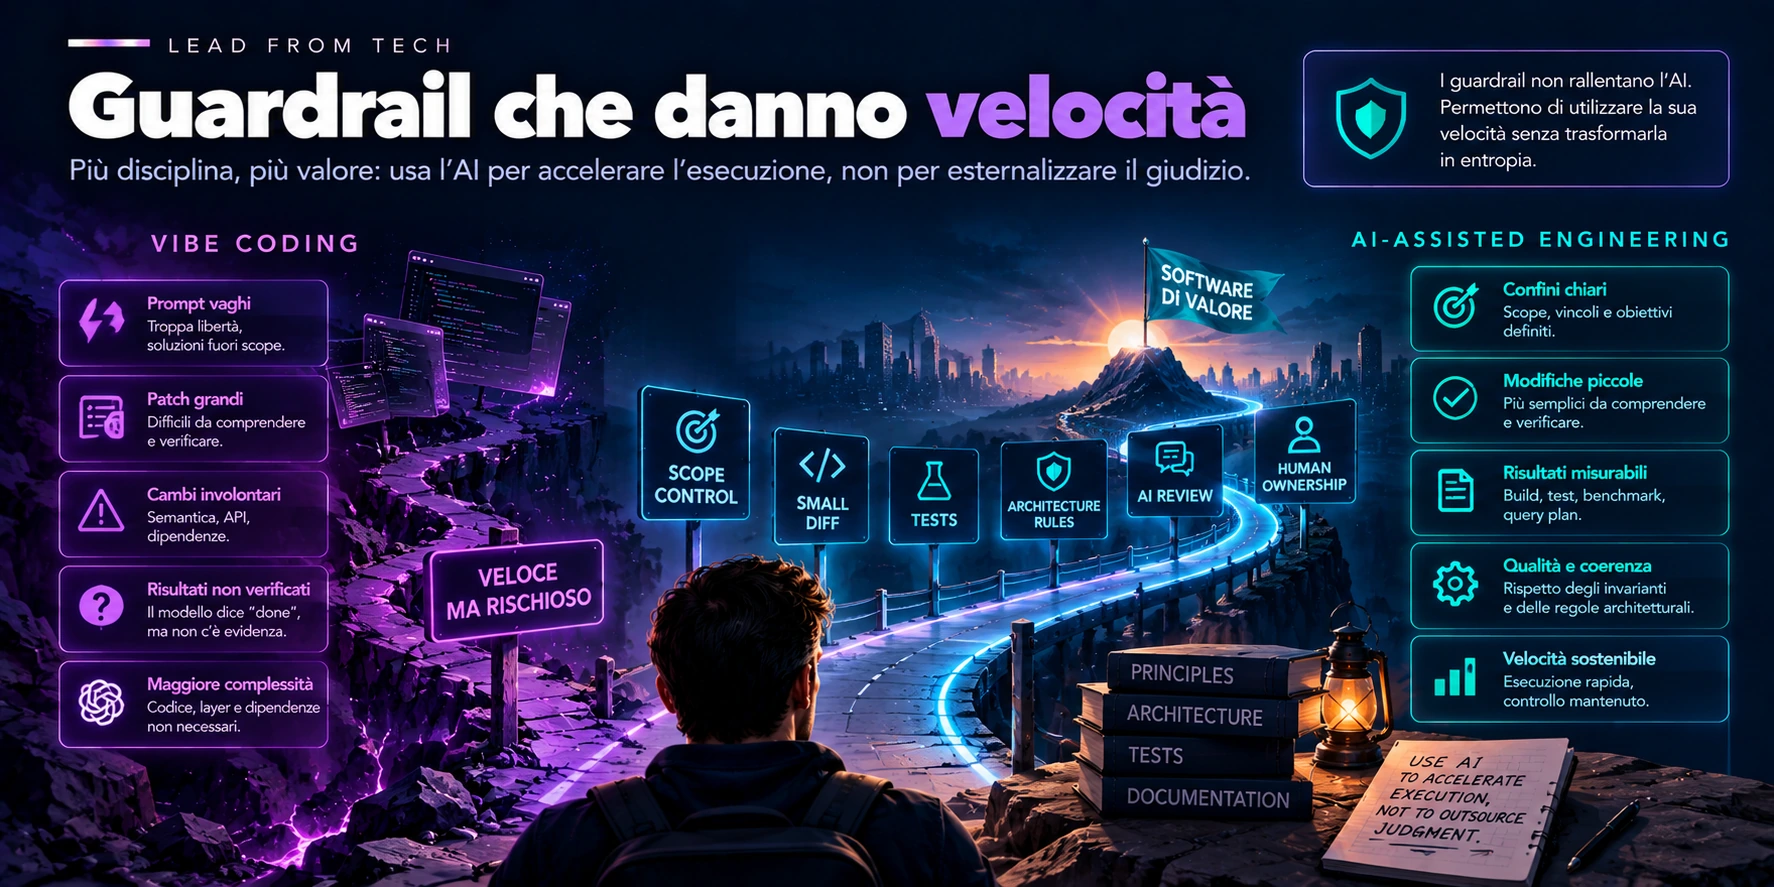
Il coding agent può esplorare rapidamente molte possibilità.
I guardrail stabiliscono quali di quelle possibilità sono accettabili nel sistema reale.
Più il modello diventa capace, meno ha senso competere con lui sulla velocità di digitazione.
Diventa più importante essere bravi a:
- definire il problema;
- fornire contesto;
- stabilire confini;
- riconoscere trade-off;
- verificare risultati;
- decidere quando fermarsi.
Il contesto diventa parte dell’ingegneria
Lavorando in questo modo emerge un’altra conseguenza.
Il contesto fornito all’AI non è più semplice “prompt engineering”.
È parte del lavoro di engineering.
Architettura.
Convenzioni.
Invarianti.
Decisioni precedenti.
Contratti.
Test.
Vincoli.
Obiettivi.
Se il modello non conosce questi elementi, può produrre codice localmente corretto e globalmente sbagliato.
Questo significa che la qualità della documentazione, la chiarezza dei confini e la leggibilità del sistema acquistano ancora più valore.
Un codebase comprensibile non aiuta soltanto le persone.
Aiuta anche gli strumenti che lavorano insieme alle persone.
Dal vibe coding all’AI-assisted engineering
Non credo che il vibe coding sia necessariamente qualcosa da evitare.
È straordinario per:
- esplorare;
- prototipare;
- imparare;
- verificare rapidamente un’idea;
- costruire una prima versione.
Il problema nasce quando lo stesso modello operativo viene trasferito senza cambiamenti su un sistema che deve essere mantenuto.
Quando il software cresce, cresce anche il costo delle decisioni sbagliate.
A quel punto serve un passaggio.
Dal:
“vediamo cosa produce”
al:
“sappiamo cosa deve cambiare, cosa non deve cambiare e come dimostreremo che la modifica è corretta.”
È lì che, per me, iniziamo a parlare di AI-assisted engineering.
L’AI accelera l’esecuzione. L’ownership resta umana.
La lezione più importante che mi porto dietro non riguarda un framework, un modello o uno strumento.
Riguarda la responsabilità.
Posso delegare all’AI una parte crescente dell’esecuzione.
Posso farle leggere codice.
Proporre architetture.
Scrivere test.
Generare patch.
Analizzare query.
Cercare regressioni.
Ma non posso delegarle l’ownership del sistema.
Qualcuno deve ancora decidere:
- cosa stiamo costruendo;
- perché;
- quali compromessi accettiamo;
- quali rischi no;
- quale evidenza consideriamo sufficiente;
- quando una modifica può entrare nel prodotto.
Ed è probabilmente questo il cambiamento più interessante introdotto dall’AI nello sviluppo software.
Non rende meno importante l’ingegneria.
Sposta il suo valore dall’esecuzione al giudizio.
La regola che mi porto dietro è questa:
use AI to accelerate execution, not to outsource judgment.
Pubblicato originariamente su LinkedIn il 20 settembre 2026. Questa edizione fa parte degli Insights di Lead From Tech.