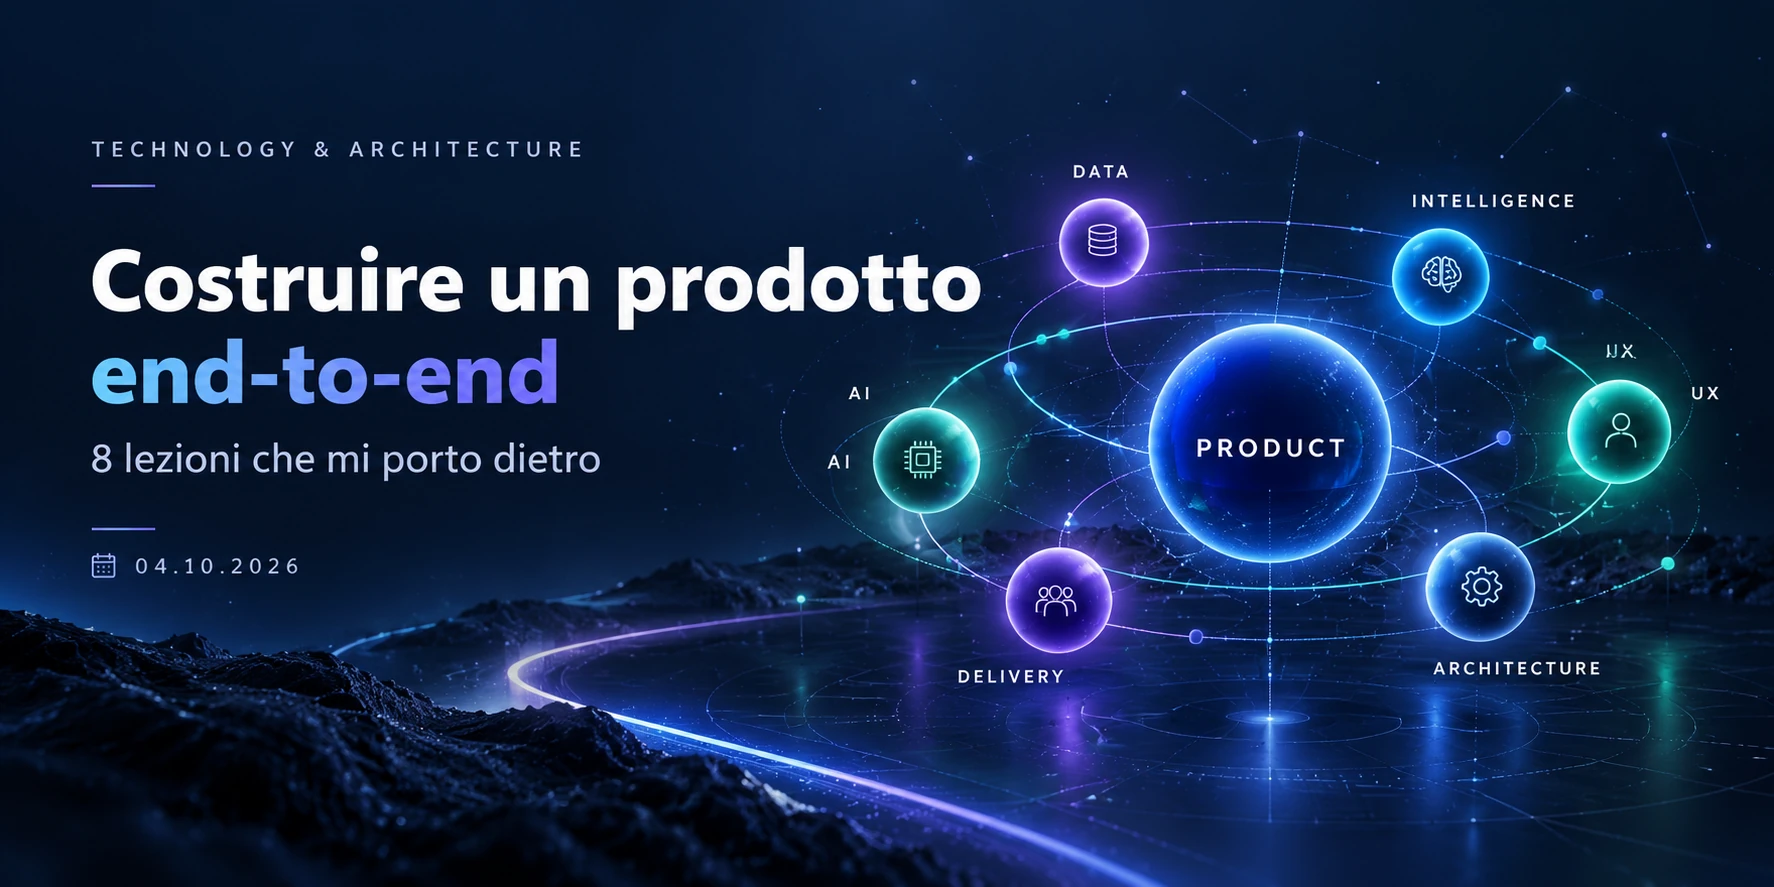
Quando ho iniziato a lavorare a PokerBeacon, il problema sembrava relativamente lineare: partire da dati grezzi, interpretarli e trasformarli in informazioni utili.
Poi la complessità ha iniziato a spostarsi.
Il parsing ha aperto il tema della qualità del dato. La qualità del dato ha portato alle metriche. Le metriche hanno richiesto confidence e benchmark. Da lì sono arrivati i segnali, l’explainability, la UX, nuovi requisiti per il backend e, infine, tutte le implicazioni di packaging, persistenza e lifecycle di un’applicazione desktop.
Nel frattempo l’AI ha accelerato lo sviluppo, ma ha reso ancora più importante distinguere velocità di esecuzione e qualità delle decisioni.
A quel punto il progetto non era più soltanto un esercizio tecnico. Era diventato un piccolo laboratorio di product engineering.
La lezione più importante è forse questa: i problemi significativi raramente rimangono confinati dentro un singolo layer.
Queste sono le otto lezioni principali che mi porto dietro.
1. Il dato non è il punto di partenza. È una responsabilità
È facile pensare al dato come a qualcosa che semplicemente arriva: un file, un evento, un record da elaborare.
Ma prima di poterlo utilizzare bisogna rispondere a domande molto meno banali: cosa rappresenta davvero? Da quale sorgente proviene? È completo? È duplicato? Possiamo fidarci della sua semantica?
Un parser può terminare senza errori e un database può contenere record formalmente validi, mentre il risultato analitico continua a essere sbagliato.
Per questo, durante il progetto, la pipeline è diventata progressivamente qualcosa di più vicino a:
source → parsing → semantic validation → normalization → persistence → analytics
e non semplicemente:
file → database
La differenza sembra piccola finché non si costruiscono decisioni sopra quei dati. A quel punto diventa fondamentale.
2. Persisti i fatti. Deriva le interpretazioni
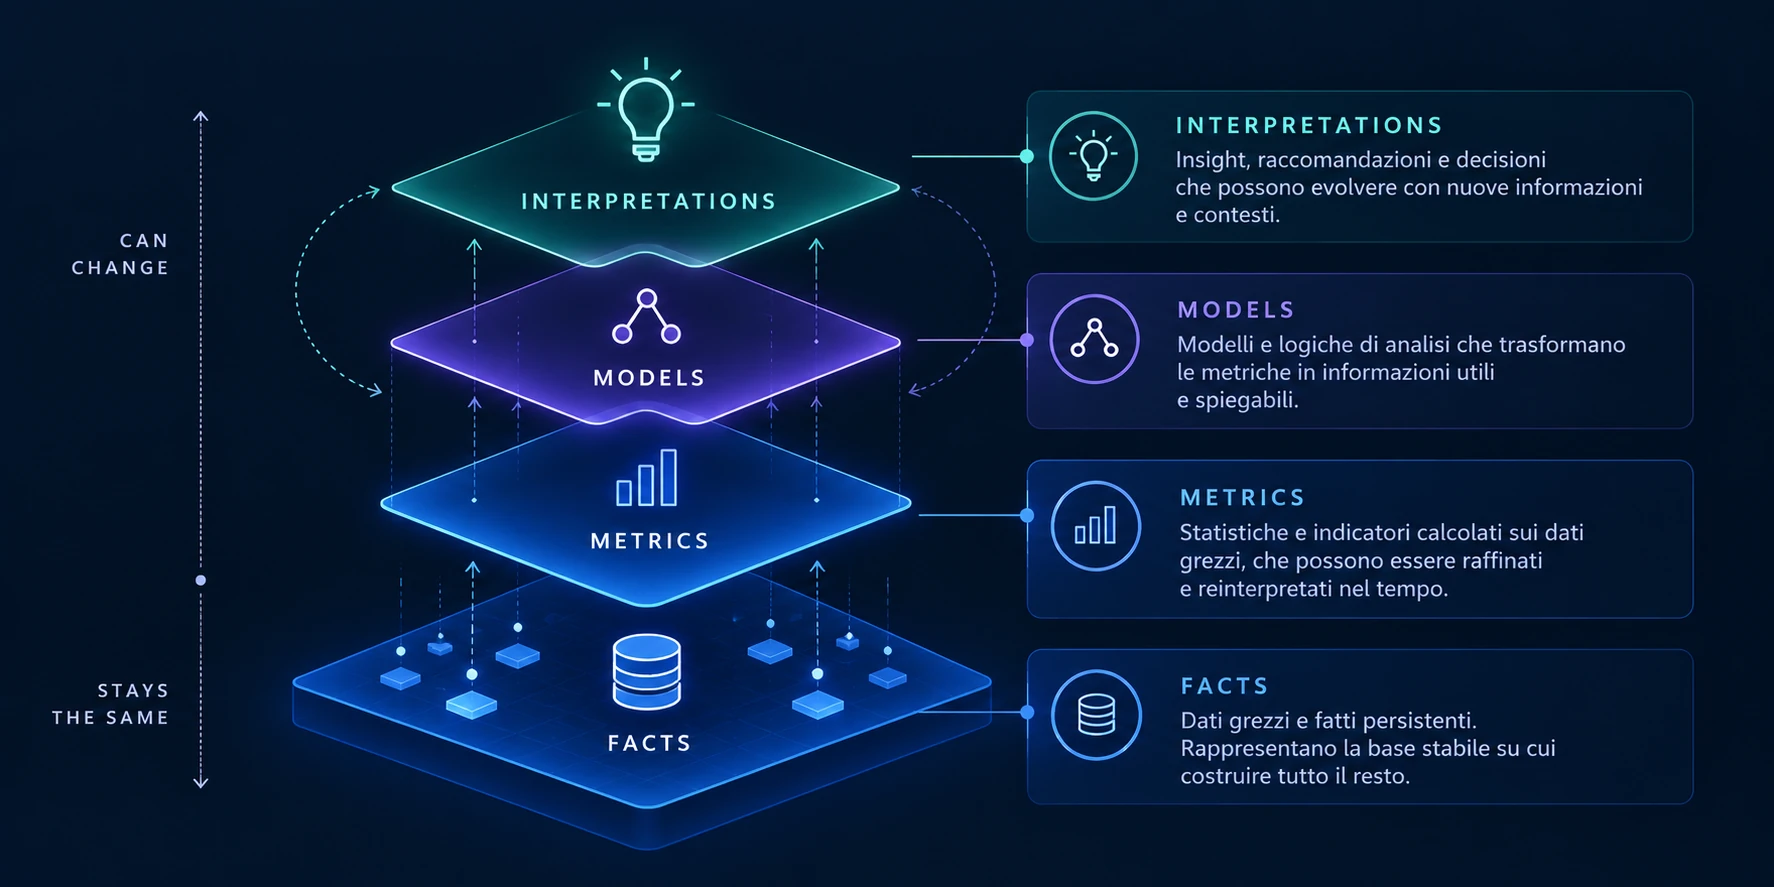
Una delle decisioni architetturali più importanti è stata separare ciò che è osservato da ciò che viene interpretato.
Una mano giocata, un’azione o un board sono fatti. Le definizioni delle metriche, le soglie, i benchmark, i segnali, gli archetipi e le regole di confidence possono invece evolvere.
Se l’interpretazione viene cristallizzata troppo presto nella persistenza, ogni cambiamento futuro rischia di trasformarsi in una riscrittura della storia.
Il principio che ne è emerso è semplice:
persist facts, derive intelligence.
È un pattern che va oltre PokerBeacon: quando gli eventi sono relativamente stabili ma il modo in cui li leggiamo può migliorare, conviene preservare i primi e lasciare evolvere il secondo.
3. Una metrica senza contesto è solo un numero
Una percentuale può essere matematicamente corretta e operativamente poco utile.
Un 80% calcolato su cinque osservazioni e un 80% calcolato su cinquecento osservazioni hanno lo stesso valore numerico, ma non raccontano la stessa cosa.
Per questo una metrica utile non è soltanto un value. Ha bisogno almeno del proprio contesto: numero di osservazioni, opportunità, confidence, benchmark e distanza rispetto alla popolazione di riferimento.
Questa scelta attraversa tutto il prodotto. Cambia il motore analitico, il contratto API, la UI e soprattutto il modo in cui l’utente interpreta ciò che vede.
Un problema apparentemente statistico diventa rapidamente un problema di prodotto.
4. Intelligence non significa produrre più conclusioni
Quando aumentano le metriche, è naturale voler aumentare anche gli insight.
Ma il valore di un sistema di intelligence non cresce in modo proporzionale al numero di badge che riesce a mostrare.
Il problema, a un certo punto, diventa l’opposto: ridurre la complessità senza perdere informazione importante.
Cento metriche non devono necessariamente produrre cento conclusioni. Possono produrne tre, purché siano rilevanti, spiegabili, contestualizzate e verificabili.
È una forma di compressione informativa: selezionare ciò che distingue davvero un comportamento e portarlo in superficie.
È anche il punto in cui analytics e product design iniziano a sovrapporsi.
5. Explainability va progettata prima
Aggiungere una classificazione è semplice. Spiegare perché il sistema l’ha prodotta è molto più difficile.
Se una conclusione deve essere verificabile, il sistema deve conservare abbastanza contesto per ricostruirla: metriche coinvolte, opportunità, benchmark, confidence, condizioni applicate, evidenze e persino eventuali segnali contrari.
L’explainability, quindi, non è un tooltip da aggiungere alla fine.
Influenza il modello dati, il motore analitico, l’API e l’interfaccia.
La conseguenza progettuale è importante: se vogliamo spiegare una decisione domani, dobbiamo conservare oggi le informazioni che permetteranno di ricostruirla.
6. La UX non serve a mostrare tutto
Quando il prodotto ha iniziato ad accumulare dati, metriche e segnali, la completezza è diventata progressivamente nemica della leggibilità.
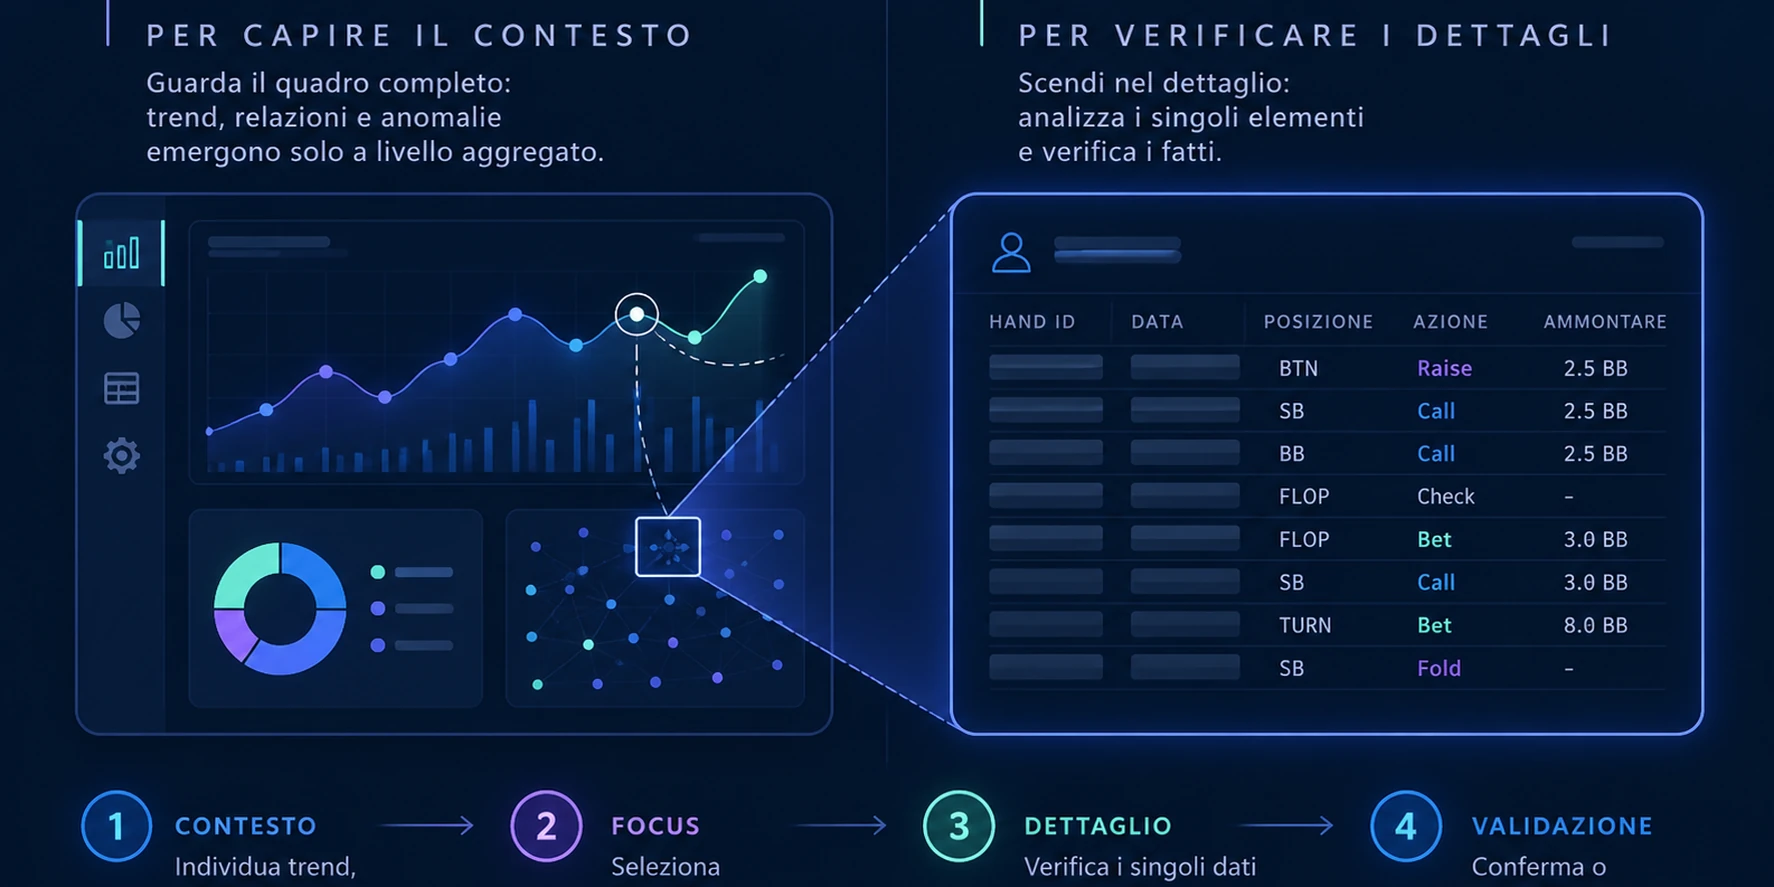
La soluzione non è stata semplicemente eliminare informazioni, ma organizzare diversi livelli di profondità.
Nel Player Profile, per esempio, il percorso è diventato:
summary → signals → metrics → hands
La sintesi orienta. Il segnale porta l’attenzione su qualcosa di interessante. La metrica spiega. Il dato elementare permette di verificare.
Da qui è nato uno dei principi più trasferibili dell’intero progetto:
zoom out per capire, zoom in per verificare.
Vale per una dashboard analitica, per un sistema di monitoring, per un report direzionale e, più in generale, per qualsiasi interfaccia che debba rendere leggibile una grande quantità di informazioni.
7. Un’applicazione desktop è comunque un sistema distribuito
“Desktop” può far pensare a un sistema semplice perché tutto viene eseguito sulla stessa macchina.
In realtà un’applicazione composta da Angular, Electron, Spring Boot, runtime Java e SQLite continua ad avere processi, lifecycle, boundary e failure mode differenti.
La shell deve avviare e controllare il backend, gestire readiness e shutdown, evitare istanze concorrenti e mantenere separati software e dati utente.
SQLite porta con sé lock, migration, backup e recoverability. Il loopback introduce considerazioni di sicurezza. Il packaging deve governare anche il runtime.
La distribuzione fisica è locale, ma la complessità sistemica rimane.
Local-first non significa architecture-free.
8. L’AI accelera tutto, comprese le decisioni sbagliate
L’AI ha cambiato radicalmente la velocità con cui è possibile analizzare codice, generare implementazioni, produrre test, documentare, fare refactoring ed esplorare alternative.
Ma la stessa accelerazione vale anche per l’overengineering, le regressioni, le astrazioni inutili e le modifiche fuori scope.
Per questo il processo è diventato sempre più esplicito:
Problem → Read → Scope → Constraints → Acceptance Criteria → Implementation → Build/Test/Benchmark → Review → Accept or Iterate
L’AI è estremamente utile nell’esecuzione, ma non elimina la responsabilità della decisione.
A volte il risultato migliore di un’analisi assistita dall’AI è capire che il codice non deve ancora essere modificato.
Il principio che mi porto dietro è quindi:
use AI to accelerate execution, not to outsource judgment.
Le parti più difficili non erano quelle che pensavo
All’inizio avrei probabilmente indicato parsing, statistiche e interfaccia come le aree più difficili.
In realtà molte delle decisioni più delicate sono emerse nei confini.
Tra dati e analytics, quando bisogna stabilire cosa rappresenta davvero un’opportunità. Tra analytics e UX, quando una confidence deve essere comunicata senza generare falsa certezza. Tra backend e frontend, quando il contratto API deve trasportare abbastanza contesto da rendere spiegabile una metrica. Tra shell desktop e backend, quando bisogna governare il lifecycle. Tra AI ed engineering, quando velocità e qualità della decisione non coincidono.
I boundary sono spesso il vero luogo della complessità.
Il prodotto ha cambiato anche il modo in cui guardo il delivery
Ottimizzare un singolo layer è relativamente semplice.
Il backend vuole contratti puliti. Il frontend vuole dati facili da consumare. Il database vuole query efficienti. La UX vuole semplicità. Il packaging vuole affidabilità.
Il prodotto deve tenere insieme tutto.
Questo porta continuamente a scegliere soluzioni che non sono perfette per un singolo componente, ma risultano migliori per il sistema complessivo.
È anche il punto in cui product engineering e delivery management diventano molto vicini: entrambi richiedono priorità, trade-off, sequencing, gestione del rischio, comprensione delle dipendenze e capacità di capire quando qualcosa è sufficientemente solido per procedere.
La soluzione migliore è spesso quella che lascia più opzioni aperte
Durante il progetto ho cercato progressivamente di evitare decisioni irreversibili prese troppo presto.
Separare il parser dal dominio. Non incorporare la sorgente nel modello. Derivare i segnali invece di persisterli come verità assolute. Separare software e dati utente. Introdurre nuove astrazioni soltanto quando esiste un problema concreto che le giustifica.
La reversibilità riduce il costo del cambiamento.
E una buona architettura, in fondo, serve soprattutto a questo: rendere il cambiamento sostenibile.
Misurare prima di ottimizzare
Molte volte qualcosa sembra lento, grande o fragile.
La tentazione è intervenire immediatamente. Ma il passo più utile è spesso misurare.
Nel progetto questo approccio ha permesso, per esempio, di verificare l’effetto reale del lazy loading sul frontend e di misurare affidabilità e throughput del parser prima di decidere se ottimizzarlo ulteriormente.
I numeri non servono a dichiarare genericamente che un prodotto è veloce o efficiente.
Servono a sapere qual è lo stato reale prima di prendere la decisione successiva.
Measure first. Optimize second.
Non tutto deve diventare una feature
Un side project genera continuamente nuove idee: metriche, visualizzazioni, segnali, filtri, classificazioni.
Ma un prodotto non migliora necessariamente aggiungendo.
A volte migliora quando si decide consapevolmente che qualcosa non entra.
Tempo, risorse e capacità cognitiva dell’utente sono limitati. Per questo la domanda non può essere soltanto “è utile?”.
Deve diventare:
è abbastanza utile da giustificare la complessità, la manutenzione e lo spazio cognitivo che introduce?
Dalla feature al sistema
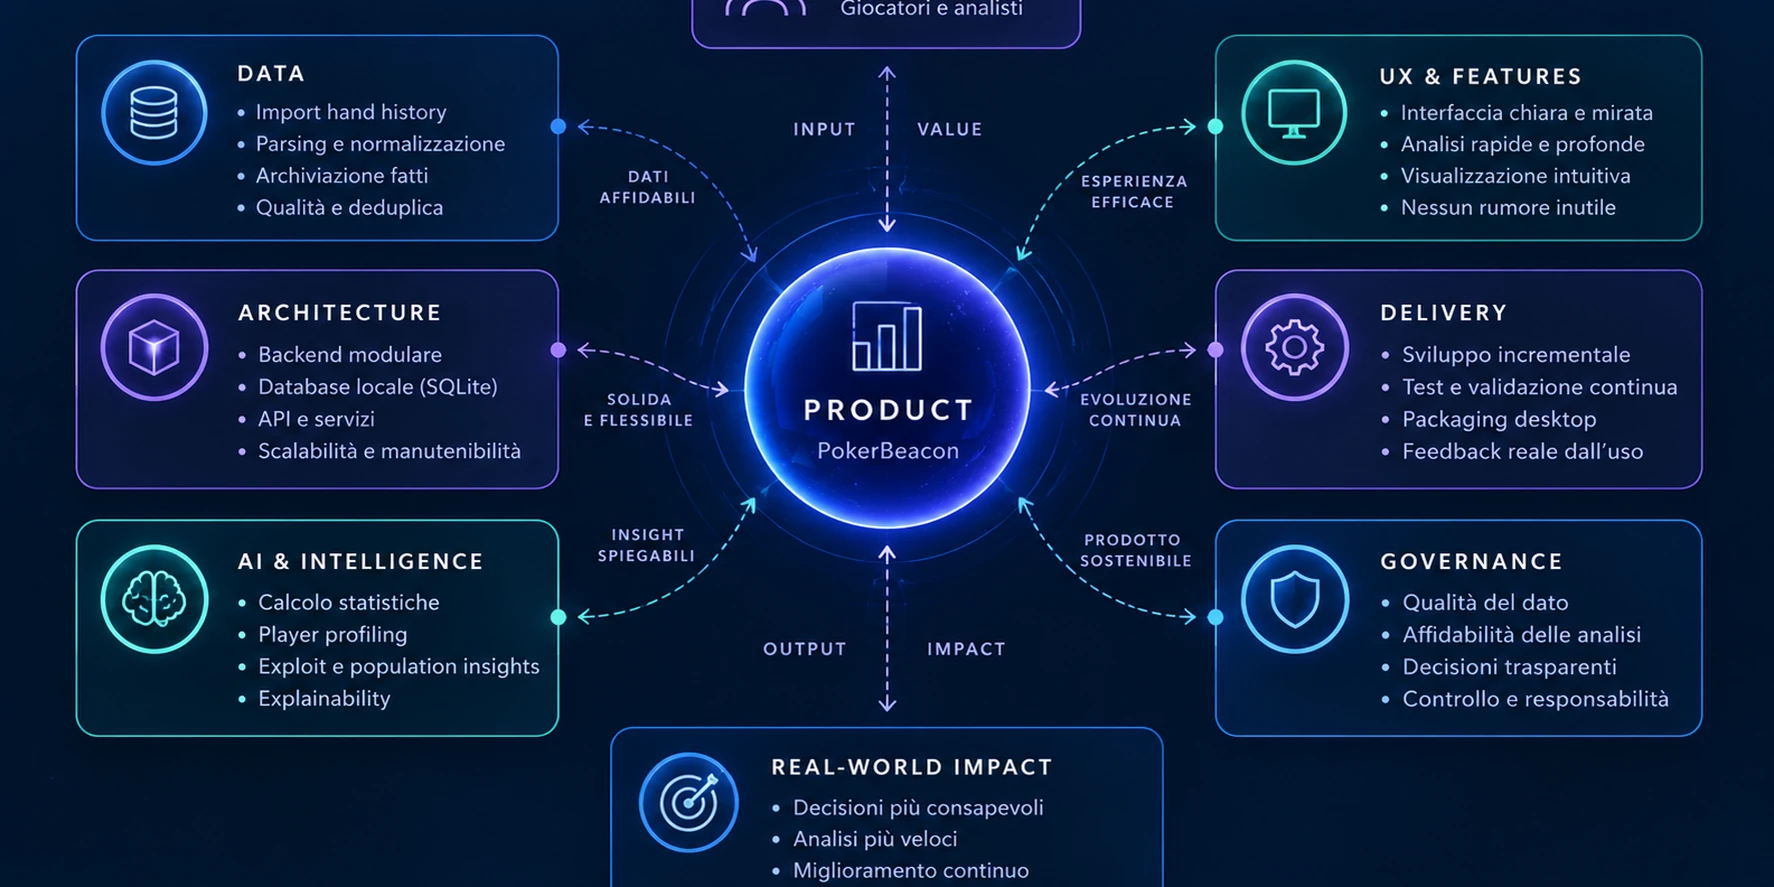
Ripercorrendo il percorso, il progetto ha attraversato progressivamente dato, architettura, data quality, statistiche, behavioral intelligence, UX e AI-assisted engineering.
Ma questi elementi non sono realmente indipendenti.
Un errore nel dato può emergere nella UI. Una scelta UX può richiedere un nuovo contratto backend. Una metrica può obbligare a ripensare il modo in cui vengono modellate le opportunità. Una decisione architetturale può cambiare il packaging. Una modifica AI-assisted può propagarsi attraverso tutti questi livelli.
Un prodotto non è la somma di layer separati.
È una rete di decisioni che si influenzano reciprocamente.
Otto lezioni, una sola idea
Se dovessi condensare tutto il percorso in una frase, sarebbe questa:
costruire un prodotto significa governare le relazioni tra problemi diversi, non risolverli uno alla volta.
Il codice conta. L’architettura conta. La qualità dei dati conta. Le metriche contano. La UX e i test contano. L’AI può accelerare quasi tutto.
Ma il valore nasce soprattutto dalla coerenza tra queste decisioni.
È probabilmente questo ciò che mi porto maggiormente dietro dal progetto: non una tecnologia o un framework, ma un modo diverso di guardare la complessità.
Non chiedersi soltanto se una soluzione funziona.
Chiedersi anche cosa cambia nel resto del sistema quando decidiamo di adottarla.
Dal prodotto al metodo
Con questo articolo si chiude la serie dedicata alla costruzione di PokerBeacon.
Il progetto continuerà naturalmente a evolvere, ma il racconto editoriale cambia prospettiva.
Molte delle domande emerse non riguardano soltanto il software. Riguardano il modo in cui prendiamo decisioni quando tecnologia, persone, processi e organizzazione devono funzionare insieme.
Quando ha senso introdurre una nuova tecnologia? Come distinguiamo un’opportunità reale da una soluzione in cerca di un problema? Come introduciamo l’AI mantenendo governance, accountability e controllo? Come misuriamo il valore? Come trasformiamo una sperimentazione riuscita in qualcosa che un’organizzazione possa adottare davvero?
Sono domande sempre più vicine al delivery e alla governance.
Ed è da qui che voglio continuare.
La prossima prospettiva: AI nei progetti
Su Lead From Tech continuerò a utilizzare casi concreti come PokerBeacon, ma con un obiettivo più ampio: trasformare esperienze tecniche in framework utili per governare tecnologia, AI e delivery.
Il prossimo filone partirà da una domanda volutamente semplice:
tutti i progetti hanno davvero bisogno dell’AI?
Parlerò di selezione dei casi d’uso, AI readiness, dati e processi, human in the loop, accountability, governance, adoption e misurazione del valore.
Sono temi che sto approfondendo anche attraverso il percorso CPMAI, ma che voglio continuare a osservare soprattutto dal punto di vista di chi deve portarli dentro progetti reali.
PokerBeacon è stato il laboratorio.
Ora il passo successivo è astrarre ciò che ho imparato.
Dal prodotto al progetto.
Dalla tecnologia alla governance.
Dall’AI come strumento all’AI come capacità da introdurre e governare dentro un’organizzazione.